
Et si la prochaine rupture du marché de l’intelligence artificielle ne venait pas d’un laboratoire californien, mais d’un calendrier avancé à Shenzhen ? Quand un géant contraint par les sanctions annonce qu’une puce prévue pour la fin 2027 arrivera dès le premier trimestre, le signal n’est pas seulement technique. Il parle de cadence industrielle, de souveraineté, de clusters monstrueux et d’une bataille commerciale qui concerne autant les fondateurs de startups que les directions marketing qui déploient déjà des modèles génératifs à l’échelle.
Lors de la conférence Huawei Connect, le groupe chinois a indiqué que l’Ascend 960DT serait prêt au premier trimestre 2027, alors que le scénario initial visait le troisième trimestre. Un porte-parole a précisé à TechCrunch que David Wang, l’un des présidents tournants, avait officialisé ce nouveau rythme. Derrière la date, il y a une promesse : des puces Ascend 960 qui arriveraient plus tôt, avec une performance annoncée comme doublée, et une progression présentée comme annuelle. Pour une audience business, IA et communication digitale, cette accélération change le calendrier d’achat, de formation des équipes et de positionnement concurrentiel.
Pourquoi cette date compte plus qu’un communiqué produit
Dans l’écosystème des accélérateurs, le temps n’est pas un détail marketing. Il détermine qui entraîne les modèles de fondation, qui industrialise l’inférence à bas coût, et qui peut vendre de la capacité de calcul comme un service. Avancer de deux trimestres, c’est compresser le cycle de conception, de validation et d’intégration système. C’est aussi envoyer un message aux clients chinois et aux partenaires asiatiques : la file d’attente ne dépend plus uniquement des exportations américaines.
Le contexte diplomatique n’est pas anodin. L’annonce intervient une semaine avant une rencontre prévue le 24 septembre à Washington entre Donald Trump et Xi Jinping. Qu’il s’agisse d’une coïncidence de calendrier ou d’une mise en scène industrielle, le marché lit ces signaux. Les fondateurs qui construisent des produits IA en Europe ou en Asie doivent déjà arbitrer entre stacks Nvidia matures et alternatives locales. Une puce plus tôt, même imparfaite, déplace le point d’équilibre des appels d’offres.
The Ascend 960DT is expected to be ready in Q1 2027. Ascend 960 chips are launching ahead of schedule, doubling performance and advancing year by year.
– Porte-parole Huawei, cité par TechCrunch
Cette citation, volontairement sobre, sert de levier narratif. Huawei ne promet pas seulement un silicium. Il promet une cadence. Dans le marketing B2B des infrastructures, la cadence rassure les acheteurs publics, les opérateurs cloud et les groupes industriels qui veulent un plan pluriannuel plutôt qu’un pari unique sur un nœud de fabrication.
Peerium : l’idée de fondre des centaines de milliers de puces en une machine
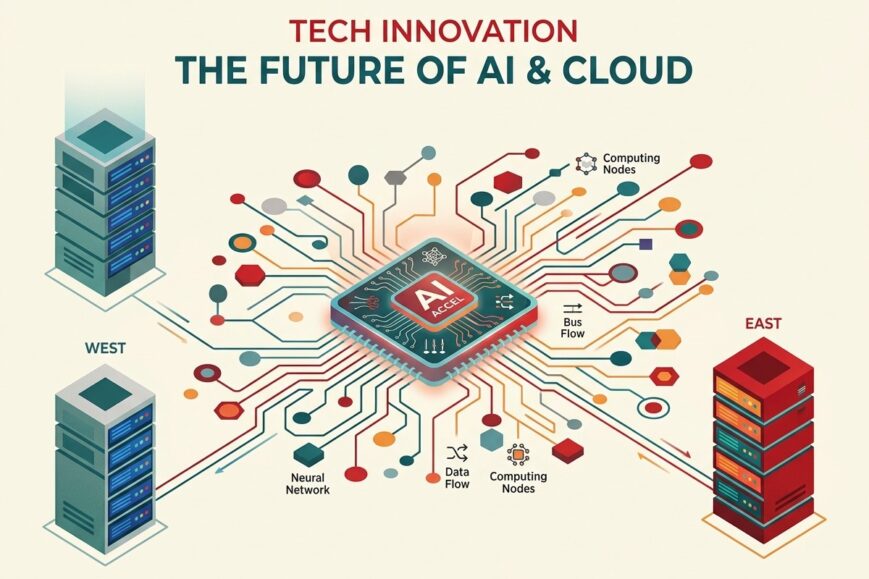
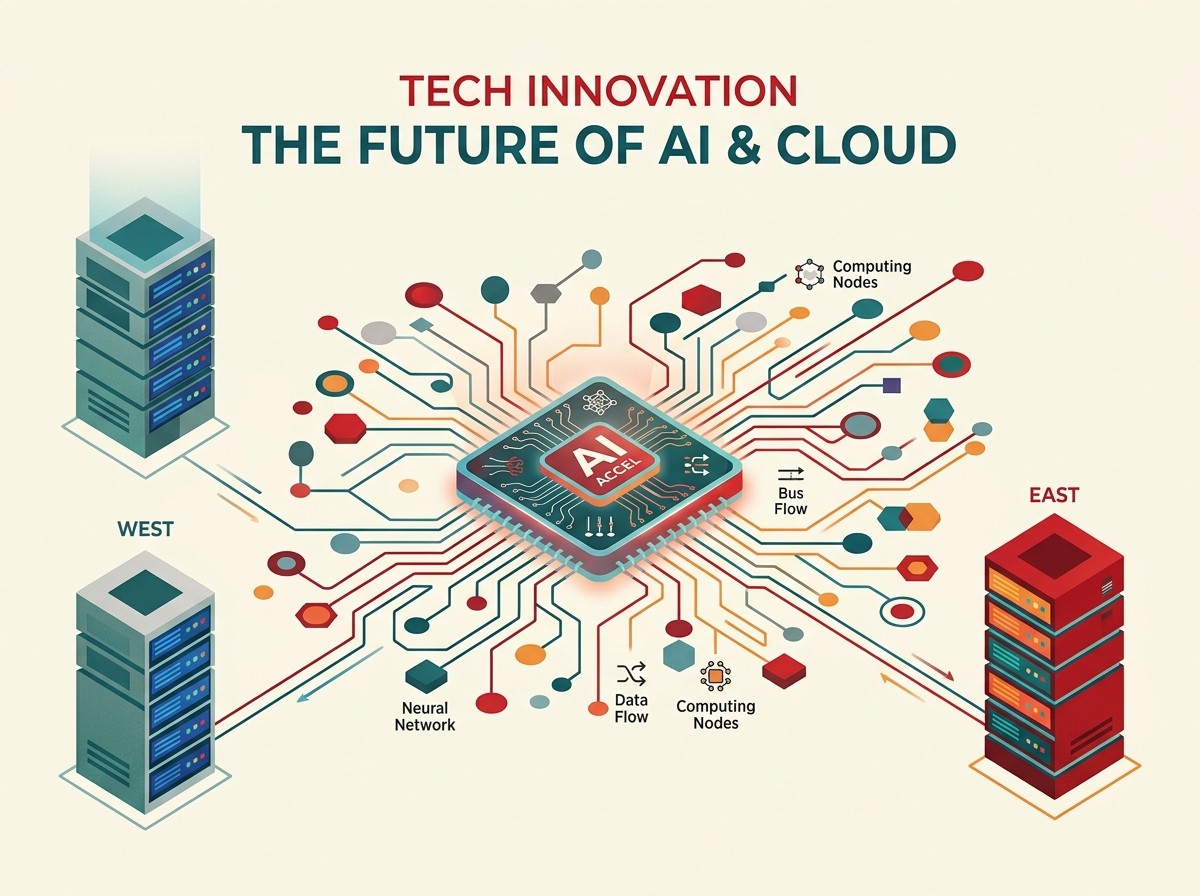
Le vrai sujet n’est pas uniquement le die. Huawei décrit une ambition systémique : transformer des centaines de milliers, puis des millions de puces IA en un seul ordinateur géant. Cette approche s’appelle Peerium Computing Architecture. Elle s’appuie sur UnifiedBus, une technologie maison destinée à relier processeurs, mémoire, stockage et réseau. Eric Xu, autre président tournant, a présenté cette architecture comme le socle de systèmes plus vastes, pensés à la fois pour l’entraînement et l’inférence.
Pour un directeur technique de startup, cette phrase a une traduction concrète. L’entraînement réclame bande passante, synchronisation et mémoire collective. L’inférence réclame densité, latence prévisible et coût par token. Une architecture qui prétend unifier les deux mondes vise le Graal commercial des années 2026-2028 : vendre le même fabric de calcul à des labos de recherche et à des plateformes grand public.
Les premiers systèmes cités sont l’Atlas 950 SuperPoD et le SuperCluster. Selon le groupe, un Atlas 950 SuperCluster pourrait interconnecter jusqu’à 256 000 cartes accélératrices. Le chiffre impressionne. Il doit aussi être lu avec prudence. Relier 256 000 cartes n’équivaut pas à obtenir 256 000 fois la performance d’une carte. Les goulets d’étranglement — réseau, cohérence mémoire, ordonnancement, pannes — mangent une partie du rêve. C’est précisément pourquoi UnifiedBus devient le personnage central de l’histoire : sans interconnexion crédible, le SuperCluster n’est qu’une affiche.
Le détail qui fâche : un SuperPoD plus petit que prévu
L’analyste Rui Ma a souligné une incohérence apparente. Huawei avait évoqué un Atlas 960 SuperPoD capable de monter à 15 488 puces Ascend 960. Or l’annonce de la semaine parlait d’un système à 4 096 puces. En d’autres termes : le silicium arriverait beaucoup plus tôt, mais le premier assemblage présenté serait nettement plus compact que la feuille de route initiale.
The chip itself is coming WAY earlier, but the SuperPoD they announced is much smaller than what they originally laid out.
– Rui Ma, analyste tech Chine
Cette remarque est précieuse pour qui lit les communiqués comme des documents de vente. Avancer une puce et reculer l’échelle d’un pod n’est pas forcément un échec. Cela peut signaler une stratégie de mise sur le marché par paliers : livrer d’abord un format industrialisable, puis agrandir. Cela peut aussi trahir des contraintes de yield, d’alimentation, de refroidissement ou de logiciel système. Pour un acheteur, la question n’est pas « 4 096 ou 15 488 ? » mais « à quelle date mon cluster réellement livré tiendra-t-il la charge de mon modèle ? »
Les équipes produit qui vendent de l’IA comme service devraient noter ce point dans leurs grilles de risque. Un constructeur peut gagner la bataille du calendrier puce et perdre celle de la densité utile. À l’inverse, un pod plus petit, mieux maîtrisé, peut devenir l’offre standard des data centers régionaux, là où l’électricité, l’eau et les compétences d’exploitation limitent les rêves de 15 000 accélérateurs dans une seule salle.
Sanctions américaines : un mur, pas forcément un arrêt
Huawei poursuit ses ambitions puces malgré les restrictions américaines sur l’accès de la Chine aux technologies semi-conducteurs avancées. Rui Ma estime qu’il est vain de vouloir stopper le développement chinois dans ce domaine, tant l’enjeu d’autosuffisance est devenu existentiel. Ce n’est pas un jugement moral. C’est un constat d’économie politique : quand un État considère le calcul IA comme une infrastructure stratégique, les coûts d’apprentissage, les rendements imparfaits et les délais allongés restent acceptables.
Pour les entreprises occidentales, le paysage se fragmente. D’un côté, l’écosystème Nvidia reste la référence logicielle, avec CUDA, un outillage mature et un réseau de partenaires. De l’autre, des stacks chinois se construisent sous contrainte, avec des compilateurs, des runtimes et des frameworks qui cherchent la parité fonctionnelle plus que l’élégance. Les startups qui exportent vers plusieurs régions devront apprendre à parler plusieurs dialects de compute, comme elles ont appris à parler plusieurs clouds.
Donald Trump a écarté les appels de certains dirigeants de l’IA à ralentir le développement pour des raisons de sûreté, au motif que les États-Unis doivent conserver leur avance face à la Chine. Eric Xu, selon le Financial Times, a inversé l’argument côté chinois : Pékin devrait accélérer pour rattraper, car les entreprises locales auraient besoin d’aller plus loin avant de comprendre pleinement et de traiter les risques des systèmes plus puissants. Deux récits, une même obsession : ne pas céder le tempo.
Ce que UnifiedBus change dans la conversation technique
Les discussions publiques sur les puces IA se concentrent trop souvent sur les FLOPS. Les architectes savent que le goulot se situe entre les puces. UnifiedBus, tel que décrit, vise à unifier le lien entre compute, mémoire, stockage et réseau. Si la promesse tient, elle réduit le coût cognitif des architectes : moins de tissus hétérogènes, moins de conversions de protocoles, moins de files d’attente invisibles.
Dans un cluster d’entraînement, chaque milliseconde de synchronisation multiplie le gaspillage énergétique. Dans un cluster d’inférence, chaque saut réseau ajoute de la latence perçue par l’utilisateur final d’un chatbot, d’un outil d’écriture ou d’un moteur de recommandation. Les directions marketing digital qui déploient des assistants sur leurs sites sous-estiment souvent cette physique. Or le temps de réponse d’un modèle est déjà un levier de conversion.
Peerium, en tant que marque d’architecture, joue aussi un rôle de storytelling industriel. Nommer le système, c’est le rendre vendable aux ministères, aux opérateurs télécoms et aux conglomérats. C’est une leçon de communication que les scale-ups européennes gagneraient à méditer : le hardware se vend mieux quand il a une grammaire, pas seulement une fiche technique.
Nvidia reste la référence, pas une statue figée
Dire que Huawei « prend Nvidia de front » est un raccourci de titre. Nvidia domine encore par l’écosystème logiciel, la disponibilité mondiale, la relation avec les hyperscalers et la capacité à itérer des architectures déjà massivement adoptées. Un challenger chinois ne gagne pas en copiant un slide de performance. Il gagne s’il offre une alternative assez bonne, assez disponible et assez souveraine pour un marché captif immense.
Le marché intérieur chinois fournit volume, data centers d’État, banques, plateformes grand public et industrie manufacturière. Ce volume peut financer des générations successives même si l’efficacité par watt reste en retrait pendant un temps. C’est le même mécanisme qui a permis à d’autres filières technologiques de rattraper par l’échelle plutôt que par l’élégance initiale.
Pour un investisseur ou un fondateur, la question utile n’est pas « Huawei va-t-il tuer Nvidia ? » mais « dans quels périmètres une stack Ascend devient-elle assez crédible pour changer mon coût de revient ? ». Les réponses varieront selon les géographies, les réglementations d’export, les exigences de conformité et la maturité des frameworks.
Implications pour les startups IA et les équipes produit
Les jeunes pousses qui entraînent des modèles spécialisés — vertical santé, juridique, industriel, e-commerce — doivent désormais cartographier trois horizons. Le premier est l’accès immédiat à du compute connu, souvent Nvidia. Le second est le coût d’inférence à 18-36 mois, là où une alternative asiatique moins chère peut casser un modèle économique. Le troisième est le risque réglementaire : héberger, entraîner ou servir depuis telle juridiction.
- Cartographier dès maintenant les runtimes compatibles hors CUDA, même de façon expérimentale.
- Séparer clairement les budgets d’entraînement et d’inférence dans les business plans.
- Prévoir des clauses contractuelles de portabilité cloud et d’accélérateurs.
- Suivre les formats de pods réellement livrés, pas seulement les slides de densité maximale.
- Intégrer le coût énergétique et la localisation des data centers dans le discours commercial.
Ces points ne sont pas de la science-fiction opérationnelle. Un directeur financier qui voit le compute représenter 30 à 60 % des charges variables d’une scale-up IA ne peut plus traiter le choix de puce comme un détail d’infrastructure. C’est une décision de marge, de pricing et parfois de survie.
Marketing, communication et récit de souveraineté
Le lancement avancé d’une puce est aussi un acte de communication. Il s’adresse aux marchés, aux talents d’ingénierie, aux gouvernements et aux médias internationaux. Huawei raconte une histoire d’autonomie : malgré l’embargo sur certaines technologies, le groupe avance, nomme des architectures, chiffre des clusters. Cette rhétorique de résilience attire les acheteurs publics et les grands comptes qui redoutent une dépendance unique.
Les marques occidentales de cloud et de logiciels devront répondre par la preuve, pas par le dénigrement. Performance réelle, outillage développeur, sécurité de la supply chain, transparence énergétique : voilà les arguments qui tiennent. Les équipes communication digitale qui travaillent pour des acteurs du compute ont intérêt à vulgariser l’interconnexion autant que le TOPS. Le public B2B devient plus exigeant.
À l’inverse, les agences et les éditeurs SaaS qui vendent de l’IA « sans friction » devraient cesser de masquer la géopolitique du silicium. Leurs clients poseront des questions sur l’origine des GPU, la résidence des données et la continuité d’approvisionnement. Mieux vaut avoir une page d’architecture honnête qu’un slogan générique sur l’innovation.
Entraînement contre inférence : deux guerres dans la même brochure
Huawei insiste sur des systèmes pensés pour les deux usages. C’est stratégique. L’entraînement reste le théâtre des records et des communiqués. L’inférence est le théâtre des revenus récurrents. Celui qui maîtrise l’inférence à grande échelle capture la valeur quand les modèles cessent d’être des démonstrations pour devenir des commodités intégrées aux CRM, aux sites e-commerce, aux centres de contact et aux outils internes.
Un SuperCluster de 256 000 cartes, s’il se concrétise un jour dans des configurations opérables, parlerait d’abord à l’entraînement de très grands modèles. Un SuperPoD à 4 096 puces parlerait davantage à des déploiements régionaux d’inférence et à des entraînements de taille intermédiaire. Les deux peuvent coexister dans une même stratégie de catalogue. Encore faut-il que le logiciel d’orchestration suive.
Les éditeurs de grands modèles de langage le savent : le coût par million de tokens décide du pricing public. Si une architecture chinoise abaisse ce coût sur son marché intérieur, elle crée un effet de ciseau concurrentiel pour les API occidentales qui voudraient y vendre. La réciproque est vraie hors de Chine, où l’outillage Nvidia reste un avantage décisif de time-to-market.
Ce que les restrictions n’empêchent pas, et ce qu’elles déforment
Les contrôles d’export ralentissent l’accès aux machines de lithographie les plus avancées, à certains outils de conception et à des composants critiques. Ils n’effacent pas les ingénieurs, les usines existantes, ni la volonté politique. Le résultat probable n’est pas un arrêt, mais une trajectoire déformée : des nœuds moins fins compensés par plus de puces, plus d’emballage avancé, plus de génie logiciel et plus de clusters.
Cette déformation a un coût énergétique et immobilier. Plus de silicium pour la même tâche, c’est plus de salles, plus de transformateurs, plus de réseaux de refroidissement. Les pays et les entreprises qui misent sur cette voie devront exceller en ingénierie de data center autant qu’en conception de puces. C’est une bonne nouvelle pour les spécialistes de l’infrastructure. C’est un casse-tête climatique et financier pour les autres.
Rui Ma résume l’idée d’une formule nette : tenter d’arrêter la Chine sur les semi-conducteurs serait vain, tant les enjeux d’autosuffisance sont élevés. On peut discuter le mot « vain ». On ne peut plus ignorer le diagnostic. Les politiques publiques occidentales devront donc viser autre chose que l’illusion d’un arrêt total : standards de sécurité, alliances industrielles, accélération de leurs propres capacités.
Calendrier diplomatique et calendrier industriel
Placer une annonce technique une semaine avant un sommet Trump-Xi n’oblige personne à y voir une manœuvre. Mais les marchés aiment les coïncidences parlantes. Chaque camp arrive à la table avec des cartes : droits de douane, licences d’export, accès au marché, récits de leadership IA. Une puce avancée de deux trimestres est une carte visible, même si le pod associé est plus petit que promis.
Les entreprises qui vendent en Chine, depuis la Chine ou vers la Chine doivent lire ces signaux comme des variables d’environnement, au même titre qu’un taux de change. Un assouplissement ciblé des licences changerait les mix d’approvisionnement. Un durcissement les figerait. Dans les deux cas, la diversification des architectures de calcul cesse d’être un luxe d’ingénieur curieux.
Lire les chiffres comme un acheteur, pas comme un fan
256 000 cartes. 15 488 puces. 4 096 puces. Doublement de performance. T1 plutôt que T3. Ces nombres font de bons titres. Ils font de mauvais contrats s’ils ne sont pas traduits en SLA. Un acheteur sérieux demandera la bande passante inter-nœuds mesurée, le taux de défaillance annuel, le logiciel de partitioning, le support des frameworks, la consommation au rack et le délai réel de livraison.
- Exiger des benchmarks d’entraînement et d’inférence sur des modèles connus, pas seulement des pics théoriques.
- Comparer le coût total de possession, énergie comprise, sur 36 mois.
- Tester la portabilité des pipelines MLOps avant de signer un volume.
- Documenter le plan B si une génération de puce glisse d’un semestre.
Cette discipline protège autant contre l’enthousiasme chinois que contre l’auto-satisfaction occidentale. Le marché des accélérateurs récompense ceux qui mesurent, pas ceux qui applaudissent.
Conséquences pour le cloud, l’e-commerce et les LLM métier
Les plateformes d’e-commerce asiatiques, déjà gourmandes en recommandation et en génération de contenus, sont des candidates naturelles à une stack locale dès qu’elle devient assez stable. Un coût d’inférence plus bas se traduit par plus d’A/B tests, plus de personnalisation, plus de vidéos générées, plus d’agents dans le service client. Le marketing digital devient alors un consommateur vorace de silicium.
Les éditeurs de CRM et d’automatisation marketing suivront. Dès qu’un accélérateur alternatif permet d’héberger des modèles privés à un prix acceptable, la promesse « vos données ne quittent pas votre région » redevient vendable. C’est un argument de fidélisation autant que de conformité. Les directions juridiques pousseront dans ce sens plus vite que les directions techniques ne l’admettront.
Pour les grands modèles de langage métier, la fragmentation du hardware impose une discipline nouvelle : quantifier, distiller, spécialiser. Moins le modèle est monstrueux, plus il tient sur des configurations imparfaites. Paradoxalement, la course aux clusters géants peut accélérer l’intérêt pour des modèles plus petits, mieux adaptés à l’inférence de marge.
Talents, outillage et dette logicielle
Une architecture nouvelle ne vit que si des ingénieurs savent la programmer. CUDA a gagné autant par l’habitude que par la performance. Peerium et UnifiedBus devront s’accompagner de documentations, de profilers, de bibliothèques et de formations. Sans cela, même un SuperCluster restera sous-utilisé, comme ces usines flambant neuves dont les lignes tournent à demi-régime faute de savoir-faire.
Les écoles d’ingénieurs, les bootcamps internes et les éditeurs d’outils de MLOps deviennent donc des pièces du puzzle géopolitique. Former un ingénieur capable de porter un entraînement d’un backend à l’autre vaut autant, parfois, qu’acheter une génération de cartes. Les startups européennes qui miseront sur cette portabilité se créeront une option réelle, pas un discours.
Il faut aussi parler dette. Chaque optimisation propriétaire accroche le code à un fournisseur. Les équipes qui écrivent trop près du métal pour gagner 12 % aujourd’hui paieront 12 mois de refactoring demain. L’annonce Huawei devrait pousser les CTO à renforcer les couches d’abstraction, pas à tout réécrire dans l’urgence.
Risques, angles morts et questions encore ouvertes
Plusieurs zones d’ombre demeurent. Quel nœud de fabrication exact ? Quelle mémoire haute bande passante réellement disponible en volume ? Quelle maturité du compilateur au jour du premier shipment T1 2027 ? Quel écart mesuré, pas annoncé, avec les références Nvidia du moment ? Et surtout, combien de systèmes Atlas 950 seront effectivement installés hors démonstrateurs ?
L’écart entre 15 488 et 4 096 puces par SuperPoD reste le symbole de ces zones grises. Il n’invalide pas l’annonce. Il impose un suivi. Les journalistes, analystes et acheteurs devront comparer les slides d’une année sur l’autre, comme on compare des comptes trimestriels, pas comme on collectionne des keynotes.
Autre angle mort : le logiciel de sûreté. Si Xu affirme qu’il faut d’abord avancer pour ensuite comprendre les risques, beaucoup d’acteurs de la gouvernance IA entendront l’inverse de ce qu’ils souhaitent. Les entreprises qui déploient des agents autonomes dans le support client ou la finance n’ont pas le luxe d’attendre d’avoir « assez avancé » pour documenter les défaillances. La course au compute n’absout pas la dette de contrôle.
Comment agir d’ici 2027 sans se tromper de combat
Entre aujourd’hui et le premier trimestre 2027, les organisations ont une fenêtre pour se préparer sans parier leur existence sur un communiqué. La démarche la plus saine consiste à traiter Huawei comme une option stratégique parmi d’autres, à instrumenter les coûts de calcul, et à refuser les récits binaires.
- Construire un tableau de bord unique du coût par token, par région et par backend.
- Lancer un pilote d’inférence sur une stack non dominante, même limité.
- Renégocier les contrats cloud avec des clauses d’accélérateurs multiples.
- Former 10 % de l’équipe ML à la portabilité plutôt que 100 % à un seul outillage.
- Relier la stratégie compute à la stratégie de communication : dire clairement où tournent les modèles.
Ces gestes sont banals. Ils sont rares. C’est souvent ainsi que se gagne un avantage discret pendant que le marché regarde les keynotes.
Ce que cette course dit du business de demain
L’histoire de l’Ascend 960DT n’est pas seulement celle d’une puce avancée de deux trimestres. C’est celle d’un monde où le calcul devient une matière première disputée, où les architectures portent des noms de marque, où la diplomatie s’invite dans les racks, et où les équipes marketing découvrent que leur latence perçue dépend d’un bus d’interconnexion conçu à des milliers de kilomètres.
Huawei tente de transformer la contrainte en récit d’accélération. Nvidia demeure la référence d’écosystème. Les sanctions déforment sans figer. Les clusters annoncés impressionnent, puis se négocient à la baisse sur le papier. Au milieu, les startups, les groupes de communication digitale et les plateformes d’IA générative doivent décider s’ils restent locataires d’une seule pile, ou s’ils apprennent à habiter plusieurs mondes de silicium.
La question posée en ouverture retrouve alors une réponse provisoire. Oui, une rupture peut naître d’un calendrier. Pas parce qu’une date magique bascule le rapport de force mondial le 1er janvier 2027, mais parce que chaque trimestre gagné ou perdu réordonne les files d’attente, les budgets et les imaginaires. Ceux qui liront l’annonce comme un simple communiqué hardware passeront à côté. Ceux qui la liront comme un signal de marché — technique, politique et commercial — auront une longueur d’avance, même s’ils n’achètent jamais une seule carte Atlas.
D’ici là, le travail utile reste ingrat et précieux : mesurer, comparer, former, contracter, et refuser de confondre un SuperCluster de présentation avec une usine qui facture. L’IA de production n’attend pas les mythes. Elle attend des puces livrées, des bus qui tiennent la charge, et des équipes capables de raconter tout cela sans jargon inutile. Sur ce terrain-là, l’annonce de Huawei n’est pas une conclusion. C’est le début d’un cycle de vérification qui durera bien au-delà du premier trimestre 2027, et que TechCrunch comme d’autres rédactions technologiques continueront de documenter au fil des preuves, pas seulement des promesses.