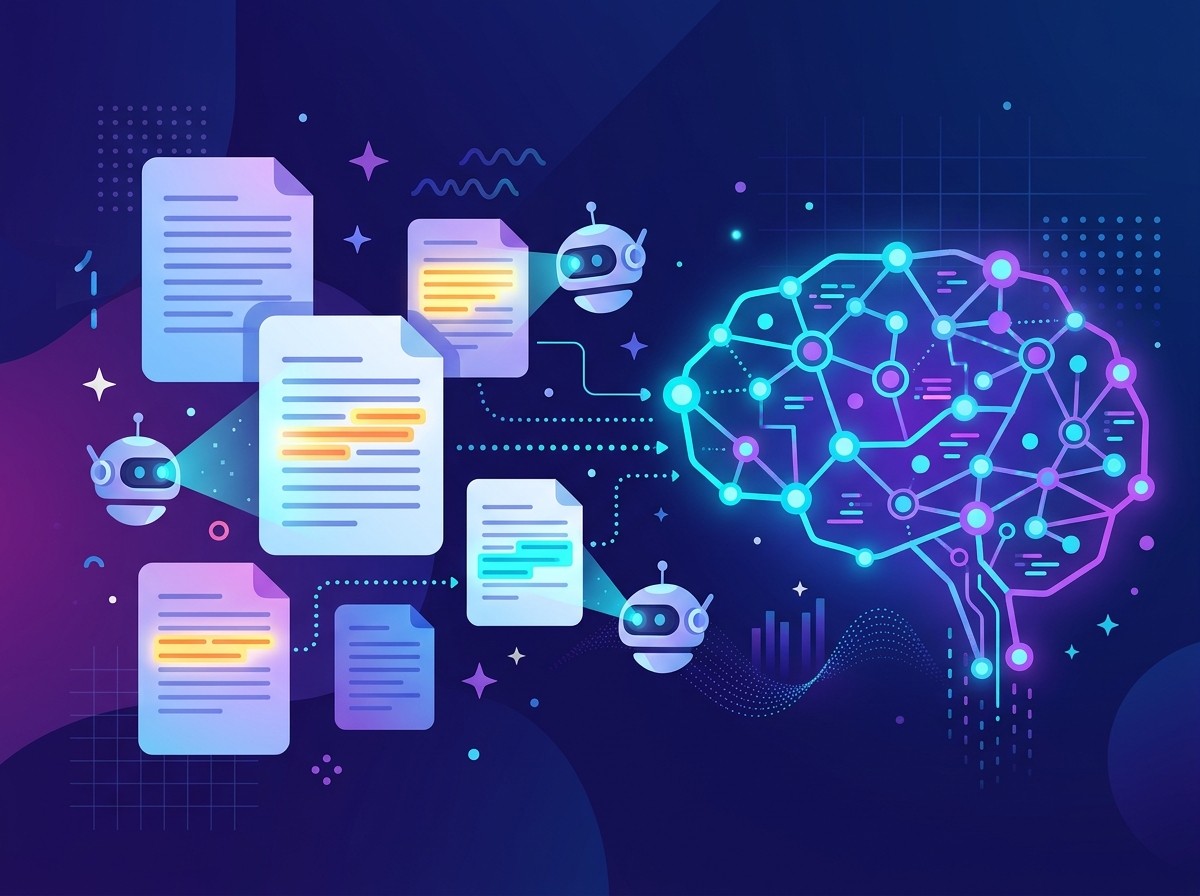

Imaginez un avocat qui, au lieu de passer des heures à feuilleter des centaines de contrats et de précédents, obtient en quelques secondes les clauses les plus pertinentes, même si les formulations diffèrent complètement. Ou un responsable marketing qui interroge l’ensemble de la documentation interne de son entreprise et reçoit des extraits ultra-ciblés sans saturer son budget tokens. C’est exactement ce que promet la nouvelle fonctionnalité dévoilée par Box lors de sa conférence développeurs : un système de récupération de contenu pensé dès le départ pour les agents intelligents, propulsé par les modèles d’embedding Nemotron de Nvidia.
Cette annonce, rapportée par TechCrunch, marque un tournant concret dans l’utilisation des agents IA en entreprise. Loin des démonstrations spectaculaires, Box et Nvidia s’attaquent à un problème très pragmatique : comment permettre à des agents autonomes de naviguer efficacement dans des millions de documents tout en respectant les permissions, en réduisant les coûts et en augmentant la précision. Le résultat s’appelle Box Content Retrieval, et il pourrait bien redéfinir la façon dont les équipes travaillent avec leurs propres données.
Une intégration stratégique entre Box et Nvidia
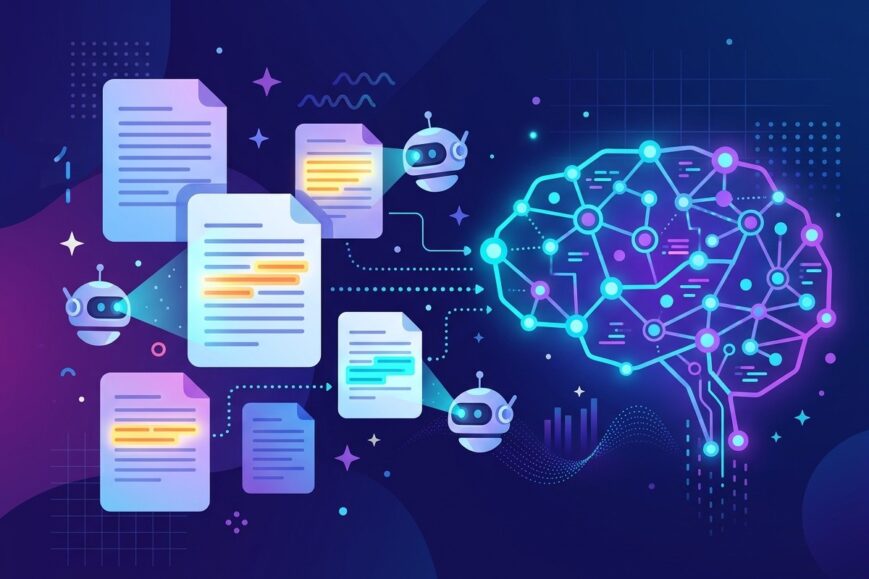
Lors de sa developer conference, Box a présenté une innovation qui place les modèles d’embedding de Nvidia au cœur de son offre. Nemotron, le projet open-weight de la société de Santa Clara, ne se contente pas de générer du texte. Il prétraite les données pour créer des représentations vectorielles riches, capables de capturer le sens profond des documents plutôt que de simples mots-clés.
Concrètement, Box Content Retrieval utilise ces embeddings pour indexeur la base documentaire des clients. Lorsqu’un agent pose une question ou reçoit une tâche, le système ne lui renvoie plus l’intégralité des fichiers. Il extrait uniquement les segments les plus pertinents, déjà enrichis par les métadonnées que Box gère depuis des années. Aaron Levie, le PDG de Box, résume l’approche avec clarté :
This dramatically boosts both the relevance of our search technology for agents. Instead of an agent having to kind of read through each document, we can send back chunks from the documents that are most relevant to the user’s query or whatever the task is that the agent is doing.
– Aaron Levie, CEO de Box
Cette phrase résume parfaitement le changement de paradigme. L’agent n’a plus besoin de tout lire. Il reçoit un contexte optimisé, ce qui accélère le raisonnement, diminue les hallucinations et fait chuter la consommation de tokens.
Des gains de performance mesurables et impressionnants
Les chiffres avancés par Nvidia sont éloquents. Kari Briski, vice-présidente en charge des logiciels d’IA générative chez le fabricant de GPU, a confié à TechCrunch que les requêtes devraient être traitées quatre fois plus rapidement, avec 20 % d’erreurs en moins et une réduction de 90 % du nombre de tokens utilisés. Ces gains ne sont pas théoriques. Ils découlent directement de la qualité des embeddings Nemotron, qui ont récemment dominé le benchmark RTEB mesurant la performance des systèmes de retrieval.
Dans un contexte où chaque token compte dans le budget cloud des entreprises, une économie de 90 % change la donne. Les équipes peuvent multiplier les interactions avec les agents sans voir la facture exploser. Pour les directions financières et les responsables IT, c’est un argument de poids. Pour les utilisateurs métier, c’est simplement une expérience plus fluide et plus fiable.
La fonctionnalité sera disponible pour tous les clients Box Enterprise Advance et déploiera progressivement au début de l’année prochaine. Cette fenêtre de déploiement laisse le temps aux entreprises de préparer leurs équipes et d’identifier les cas d’usage prioritaires.
Pourquoi les embeddings changent tout pour les agents
Les grands modèles de langage excellent dans la génération et le raisonnement, mais ils restent limités par la fenêtre de contexte et par le coût de traitement. Les systèmes de retrieval classiques, basés sur des mots-clés ou des embeddings basiques, peinent souvent à comprendre les nuances. Nemotron Embed comble cette lacune. En mappant les concepts sous-jacents plutôt que les termes exacts, le modèle permet de retrouver des informations même lorsque le vocabulaire diffère.
Prenons l’exemple des cabinets d’avocats cité par Box. Un agent peut rechercher des clauses relatives à la « limitation de responsabilité » et faire surface des passages parlant de « plafond d’indemnisation » ou de « exclusion de dommages indirects », parce que les embeddings ont capturé la proximité sémantique. Cette capacité ouvre des perspectives immenses dans le juridique, la conformité, les ressources humaines ou encore la recherche et développement.
Les équipes marketing et communication ne sont pas en reste. Imaginez un agent capable de parcourir l’ensemble des briefs, des études de marché et des retours clients pour proposer des arguments cohérents avec le positionnement de la marque, sans jamais sortir du cadre documentaire validé. La pertinence augmente, le risque de dérive diminue.
L’avantage concurrentiel de Box : métadonnées et permissions
Si les modèles Nemotron sont open-weight et donc accessibles à tous, Box insiste sur un point crucial : la force de sa solution réside dans l’alliance entre ces embeddings et son infrastructure existante. Aaron Levie le dit sans détour : « We’re probably packing in five different technologies into one simple API. » Métadonnées riches, contrôles d’accès granulaires, historique des versions, classification automatique… tout cela s’intègre dans une API unique que les développeurs peuvent appeler facilement.
Cette combinaison rend la reproduction difficile. Un concurrent qui se contenterait de brancher Nemotron sur un simple stockage de fichiers n’obtiendrait pas le même niveau de sécurité ni de pertinence. Les permissions restent respectées : un agent ne peut jamais récupérer un document auquel l’utilisateur n’a pas accès. Dans un monde où les fuites de données via les outils d’IA font la une, cet aspect rassure les directions juridiques et les RSSI.
Pour les startups et les scale-ups qui s’appuient déjà sur Box pour centraliser leurs documents, l’arrivée de Content Retrieval représente une extension naturelle de leur stack. Elles n’ont pas besoin de migrer leurs données ni de reconstruire leurs workflows de gouvernance.
Cas d’usage concrets pour les entreprises
Au-delà de l’exemple juridique, plusieurs secteurs peuvent tirer un bénéfice immédiat de cette technologie. Voici quelques scénarios réalistes :
- Dans les cabinets de conseil, un agent peut préparer une note de synthèse en croisant des rapports clients antérieurs et des études sectorielles internes, tout en respectant les clauses de confidentialité.
- Les équipes produit peuvent interroger l’historique des spécifications, des tickets support et des retours utilisateurs pour identifier rapidement les patterns récurrents.
- Les services RH gagnent en efficacité pour répondre aux questions réglementaires ou pour préparer des dossiers de mobilité interne à partir de l’ensemble des politiques et des évaluations.
- Les directions marketing accèdent à une mémoire collective enrichie : guidelines de marque, performances passées des campagnes, analyses concurrentielles, le tout filtré par pertinence sémantique.
Dans chacun de ces cas, la réduction du temps de recherche se transforme en gain de productivité mesurable. Les collaborateurs passent moins de temps à chercher et plus de temps à décider ou à créer.
Le positionnement de Nvidia sur les modèles d’embedding
Nvidia a clairement choisi de faire des embeddings un axe stratégique de son initiative open-source. Alors que de nombreux laboratoires se concentrent exclusivement sur les modèles de génération, Nvidia a investi massivement dans les modèles de retrieval. Le succès de Nemotron sur le benchmark RTEB en juillet dernier n’est pas un hasard. Il reflète une vision où la qualité de la récupération d’information devient aussi importante que la qualité de la génération.
Cette approche open-weight favorise l’adoption. Les entreprises peuvent expérimenter, fine-tuner et déployer les modèles sur leur propre infrastructure si elles le souhaitent. Mais l’intégration native dans Box offre un chemin beaucoup plus simple pour la majorité des organisations qui préfèrent une solution managée, sécurisée et immédiatement opérationnelle.
Le partenariat illustre aussi la stratégie plus large de Nvidia : ne pas se contenter de vendre des GPU, mais devenir un acteur incontournable de la stack logicielle d’IA d’entreprise. En fournissant les briques de retrieval, Nvidia s’assure une présence durable dans les workflows critiques.
Impact sur les coûts et l’adoption des agents IA
L’un des freins majeurs à l’adoption massive des agents intelligents reste le coût d’inférence. Plus un agent lit de documents, plus il consomme de tokens, plus la facture grimpe. En divisant presque par dix la consommation, Box Content Retrieval abaisse considérablement cette barrière. Les entreprises peuvent désormais envisager des agents qui tournent en continu, qui traitent des dizaines de requêtes par employé et par jour, sans que le budget cloud ne devienne prohibitif.
Cette réduction de coût s’accompagne d’une amélioration de la précision. Moins d’erreurs signifie moins de relectures humaines, moins de corrections et davantage de confiance dans les réponses fournies par les agents. Le cercle vertueux est évident : plus les agents sont fiables et économiques, plus les équipes les utilisent, plus elles génèrent de valeur.
Pour les startups qui construisent des produits autour des agents, cette annonce offre aussi une opportunité. Elles peuvent s’appuyer sur l’API de Box pour proposer des solutions verticales (juridique, finance, santé) sans avoir à reconstruire toute la couche de retrieval et de gouvernance documentaire.
Les défis restants et les questions ouvertes
Malgré l’enthousiasme, plusieurs questions demeurent. La qualité des embeddings dépend toujours de la qualité des documents sources. Si les fichiers sont mal organisés, obsolètes ou incomplets, même le meilleur modèle de retrieval ne fera pas de miracles. Les entreprises devront continuer à investir dans la gouvernance de l’information et dans la qualité des métadonnées.
La question de la latence en conditions réelles, avec des bases documentaires de plusieurs téraoctets, reste également à valider à grande échelle. Les chiffres avancés par Nvidia sont prometteurs, mais chaque architecture d’entreprise est unique. Les premiers retours des clients Enterprise Advance seront donc particulièrement suivis.
Enfin, l’intégration avec d’autres agents et orchestrateurs (LangChain, LlamaIndex, solutions propriétaires) devra être fluide pour que Box Content Retrieval devienne un standard de fait. L’API simple promise par Aaron Levie laisse penser que Box a anticipé ce besoin d’interopérabilité.
Ce que cela signifie pour l’écosystème marketing et business
Dans le monde du marketing digital et des startups, l’accès à une mémoire d’entreprise intelligente change la donne. Les équipes de contenu peuvent s’appuyer sur des agents capables de retrouver instantanément les messages validés, les études de persona et les retours de campagnes passées. Les responsables de la croissance peuvent croiser des données clients internes avec des analyses de marché sans multiplier les allers-retours manuels.
Cette capacité renforce aussi la cohérence de marque. Lorsqu’un agent dispose d’un accès sémantique à l’ensemble des guidelines et des exemples validés, le risque de produire des messages hors-piste diminue fortement. Pour les entreprises multi-marques ou multi-marchés, l’avantage est encore plus marqué.
Du côté des investisseurs et des décideurs, l’annonce illustre une tendance de fond : la valeur ne se crée plus seulement dans les modèles de génération, mais dans la capacité à connecter intelligemment ces modèles aux données propriétaires des entreprises. Les plateformes qui sauront offrir à la fois la puissance des LLM et la pertinence du retrieval sécurisé prendront une longueur d’avance.
Une étape vers des agents vraiment autonomes
Box Content Retrieval ne transforme pas encore les agents en collaborateurs totalement autonomes. Mais il lève l’un des principaux obstacles techniques qui freinaient leur efficacité. En fournissant un contexte précis, réduit et sémantiquement riche, le système permet aux agents de se concentrer sur le raisonnement et l’action plutôt que sur la recherche brute d’information.
Dans les mois qui viennent, on peut s’attendre à voir apparaître des cas d’usage de plus en plus sophistiqués : agents qui préparent des dossiers complets, qui surveillent en continu la conformité documentaire, ou qui génèrent des propositions commerciales en s’appuyant sur l’historique des deals gagnés. Chaque nouveau cas d’usage renforcera la valeur de la couche de retrieval.
L’approche « agent-first » choisie par Box est particulièrement intéressante. Au lieu d’adapter un moteur de recherche traditionnel aux agents, l’entreprise a conçu le système en pensant d’abord aux besoins des agents. Cette inversion de priorité pourrait inspirer d’autres éditeurs de logiciels d’entreprise.
Perspectives pour 2027 et au-delà
Le déploiement prévu début 2027 laisse le temps aux équipes techniques de Box de peaufiner l’intégration et aux clients de se préparer. On peut anticiper que les premiers retours d’expérience influenceront les évolutions suivantes : fine-tuning spécifique par secteur, intégration plus poussée avec les outils de productivité, ou encore support de formats multimédias plus riches.
Nvidia, de son côté, continuera sans doute à améliorer les modèles Nemotron. Chaque gain de performance sur les benchmarks de retrieval se traduira potentiellement par de nouveaux records de vitesse et de précision côté Box. La boucle d’innovation entre le fournisseur de modèles et l’éditeur de plateforme semble bien engagée.
Pour les entreprises qui hésitent encore à déployer des agents à grande échelle, cette annonce offre un argument concret : il est désormais possible de réduire drastiquement les coûts et d’augmenter la fiabilité sans renoncer à la sécurité et à la gouvernance des données. Le frein économique et le frein technique s’affaiblissent simultanément.
Comment les équipes peuvent se préparer dès maintenant
Même si la fonctionnalité n’est pas encore disponible, les organisations peuvent agir dès aujourd’hui. Voici quelques pistes concrètes :
- Auditer la qualité et la structure de la base documentaire existante sur Box.
- Enrichir les métadonnées manquantes ou incohérentes pour maximiser la pertinence future des embeddings.
- Identifier les processus métier où la recherche d’information représente aujourd’hui un goulot d’étranglement.
- Former les équipes aux bonnes pratiques de formulation de requêtes pour les agents.
- Évaluer les cas d’usage prioritaires en fonction du ROI potentiel (juridique, support client, marketing, RH…).
Ces préparatifs permettront de tirer immédiatement profit de Box Content Retrieval dès son activation. Les entreprises qui arriveront prêtes gagneront un avantage concurrentiel tangible sur celles qui attendront le déploiement pour commencer à réfléchir.
Une illustration de la maturité de l’IA d’entreprise
L’annonce de Box et Nvidia illustre parfaitement le passage de l’IA générative « wow » à l’IA générative « utile et rentable ». Après des mois d’expérimentations et de preuves de concept, les entreprises demandent désormais des solutions qui s’intègrent dans leurs process existants, qui respectent leurs contraintes de sécurité et qui délivrent un retour sur investissement mesurable. Box Content Retrieval coche toutes ces cases.
En s’appuyant sur des modèles open-weight de haute qualité et en les combinant avec une plateforme de contenu déjà largement adoptée, les deux entreprises proposent une voie pragmatique vers des agents réellement productifs. Ce n’est plus seulement une question de technologie spectaculaire, c’est une question d’efficacité opérationnelle.
Pour les professionnels du marketing, des startups et de la transformation digitale, le message est clair : la compétition ne se jouera plus seulement sur la puissance des modèles, mais sur la qualité de l’accès aux données propriétaires. Ceux qui sauront connecter intelligemment leurs agents à leur mémoire d’entreprise prendront une longueur d’avance durable.
Box Content Retrieval, propulsé par Nemotron, n’est qu’une première étape. Mais c’est une étape significative, concrète et immédiatement actionnable. Dans un marché où les annonces d’IA se multiplient, celle-ci se distingue par son ancrage dans les besoins réels des entreprises et par des gains de performance quantifiés. C’est précisément ce dont l’écosystème avait besoin pour passer à la vitesse supérieure.
Les prochains mois diront si d’autres acteurs suivront rapidement cette voie « agent-first ». En attendant, les clients Box Enterprise Advance disposent d’un outil prometteur pour transformer leur base documentaire en véritable avantage concurrentiel intelligent. Et dans un monde où l’information est le nouvel or noir, savoir la retrouver vite, précisément et à moindre coût n’est plus un luxe : c’est une nécessité stratégique.