
Et si le prochain gain de productivité de votre équipe marketing ne venait pas d’un modèle plus puissant, mais d’un modèle nettement moins cher et bien plus rapide ? Depuis le 7 octobre 2026, Anthropic a mis sur le marché Claude Haiku 5.5, son petit modèle le plus agressif en prix et en vitesse. Facturé à seulement 0,10 $ le million de tokens en entrée (dix fois moins que Haiku 4.5), il change déjà la façon dont certaines entreprises structurent leurs pipelines d’IA. La question n’est plus « est-ce que ce modèle est intelligent ? », mais « quelles tâches professionnelles peut-on réellement lui confier sans perdre en qualité ? ».
Les benchmarks indépendants d’Artificial Analysis placent Haiku 5.5 à 43 points sur l’Intelligence Index en effort maximal, loin devant son prédécesseur (17 points) et légèrement devant GPT-6 Luna ou Gemini 3.8 Flash. Pourtant, derrière ces chiffres se cachent des écarts importants selon les usages. Certains workflows deviennent immédiatement rentables. D’autres restent clairement réservés aux modèles plus lourds comme Sonnet 5.5 ou Opus 5.5. Cet article décortique précisément ce que vous pouvez déléguer à Haiku 5.5 dès aujourd’hui, et ce que vous devriez encore éviter.
Claude Haiku 5.5 en chiffres : ce que disent vraiment les benchmarks
Pour comprendre l’intérêt de ce modèle, il faut regarder au-delà du simple tarif affiché. Artificial Analysis, organisme indépendant reconnu pour ses évaluations, a mesuré Haiku 5.5 à 43 points sur son Intelligence Index en mode effort maximal. Ce score agrège dix évaluations différentes : travail de bureau agentique, code en terminal, raisonnement, traitement de documents professionnels et gestion de contexte long. À titre de comparaison, Haiku 4.5 plafonnait à 17 points, GPT-6 Luna atteint 38, Gemini 3.8 Flash 41 et Sonnet 5.5 grimpe à 56.
Sur l’évaluation privée AA-Briefcase, dédiée au travail de bureau, Haiku 5.5 obtient 1 578 points Elo. Ce résultat le place dans l’intervalle de confiance de modèles nettement plus chers. Pour un modèle facturé à ce niveau de prix, c’est l’un des chiffres les plus surprenants des derniers mois.
Attention cependant : ce score de 43 points est obtenu uniquement en effort maximal. En réglage medium (par défaut), Artificial Analysis mesure 34 points pour un coût d’environ 0,05 $ par tâche de son indice. En low, on tombe à 29 points pour 0,02 $. En xhigh, on monte à 41 points pour 0,12 $. La différence de performance a donc un prix réel en tokens de sortie.
Le point faible le plus marqué reste la fiabilité factuelle. Sur le benchmark AA-Omniscience, Haiku 5.5 ne donne que 36 % de bonnes réponses lorsqu’il doit s’appuyer uniquement sur ses connaissances internes. C’est inférieur à GPT-6 Luna (44 %) et à Gemini 3.8 Flash (55 %). En revanche, son taux d’hallucination tombe à 40 %, contre 77 % pour Luna. Autrement dit, le modèle préfère souvent avouer qu’il ne sait pas plutôt que d’inventer une réponse. C’est une caractéristique importante pour les usages professionnels : il travaille bien sur l’information qu’on lui fournit, nettement moins bien sur celle qu’il est censé connaître seul.
Tarification et seuil critique des 100 000 tokens
Le tarif public d’Anthropic pour Haiku 5.5 s’établit à 0,10 $ en entrée et 0,50 $ en sortie par million de tokens, tant que le prompt reste sous 100 000 tokens. Au-delà de ce seuil, le prix est multiplié par cinq : 0,50 $ en entrée et 2,50 $ en sortie. Cette règle change complètement l’équation économique pour certains cas d’usage.
Prenons un exemple concret. Une agence qui résume 10 000 documents par mois, avec 5 000 tokens en entrée et 500 tokens en sortie par document, paie environ 7,50 $ avec Haiku 5.5. La même charge coûtait 75 $ avec Haiku 4.5 et monte à 150 $ avec Sonnet 5.5. L’économie est massive… à condition de rester sous le seuil des 100 000 tokens.
Si vous analysez 1 000 documents de 120 000 tokens avec 1 000 tokens de réponse chacun, la facture grimpe à environ 62,50 $. En découpant chaque document en deux moitiés de 60 000 tokens, le coût retombe à 12,50 $. Le découpage a toutefois ses limites : le modèle perd alors la vision d’ensemble. Selon Anthropic, 90 % des requêtes envoyées à Haiku 4.5 restaient de toute façon sous le seuil. Avec le nouveau tokenizer, la baisse de coût moyenne annoncée par l’éditeur avoisine les 75 %.
Avant toute bascule, la première chose à faire est de demander à votre équipe technique la distribution réelle de la taille de vos prompts dans les logs actuels. Si une part significative dépasse déjà 100 000 tokens, l’économie devient beaucoup moins intéressante. Si presque tout reste en dessous, et que vous activez le cache en lecture (facturé 0,01 $ le million de tokens), la marge de manœuvre devient considérable.
Les tâches professionnelles à confier en priorité à Haiku 5.5
Le dénominateur commun des bons cas d’usage est simple : des tâches courtes, cadrées, répétées à fort volume, où la source d’information est fournie dans le prompt. Voici les domaines où Haiku 5.5 brille vraiment.
Classification, tri et routage à grande échelle
Tickets de support, leads entrants, avis clients, intentions de recherche SEO… Toutes ces opérations de classification se prêtent parfaitement au modèle. Vous pouvez démarrer en effort low ou medium pour maximiser le rapport qualité/prix. Le gain de latence se fait immédiatement sentir : Artificial Analysis mesure entre 178 et 188 tokens par seconde selon le réglage, une vitesse que les utilisateurs finaux ressentent réellement.
Dans un contexte marketing, cela signifie pouvoir router automatiquement des milliers de messages par jour vers la bonne équipe, le bon niveau de priorité ou le bon scénario d’emailing, sans faire exploser la facture API.
Résumés récurrents et reporting automatisé
Comptes rendus de réunion, reporting hebdomadaire, veille concurrentielle, synthèses financières… Box a déjà annoncé vouloir utiliser Haiku 5.5 pour ce type de tâches. L’entreprise rapporte un score supérieur de 11 points à Haiku 4.5 pour une latence divisée par deux. Pour les équipes marketing qui produisent chaque semaine des synthèses de performance, de contenu ou de marché, le modèle devient un exécutant de confiance.
Extraction et questions-réponses sur documents fournis
Contrats, appels d’offres, fiches fournisseurs, catalogues produits… Tant que le document est fourni dans le contexte, Haiku 5.5 se montre très solide. AlphaSense a mesuré un score de 0,84 contre 0,76 pour Haiku 4.5 sur 400 requêtes réelles. C’est précisément le type d’usage où le modèle excelle : il n’a pas besoin de « savoir » les informations par cœur, il doit simplement les retrouver et les reformuler correctement.
Hygiène CRM et normalisation de données
HubSpot a annoncé un score de 92,8 % sur sa suite de tâches CRM, le meilleur résultat observé par l’entreprise sur un petit modèle. Déduplication, enrichissement, catégorisation de contacts, normalisation d’attributs… Ces opérations de fond, souvent répétitives et volumineuses, deviennent enfin économiques à grande échelle.
Catalogue e-commerce et extraction d’attributs
Catégorisation de produits, extraction d’attributs à partir de fiches fournisseurs, normalisation de données produit… Les équipes e-commerce qui gèrent des milliers de références peuvent considérablement réduire leurs coûts de traitement tout en gardant un niveau de qualité acceptable. Là encore, la clé reste de fournir le contexte source plutôt que de demander au modèle de « connaître » le produit.
Support client de premier niveau avec escalade
Haiku 5.5 est parfaitement adapté au support de niveau 1, à condition de prévoir une escalade claire vers un modèle plus puissant ou vers un humain pour les cas complexes. Sa vitesse élevée améliore l’expérience utilisateur, et son faible coût permet de traiter un volume important sans surcoût prohibitif.
Deux usages avancés particulièrement intéressants
Au-delà des tâches classiques, deux patterns d’architecture se dessinent comme particulièrement rentables avec Haiku 5.5.
Utiliser Haiku 5.5 comme sous-agent
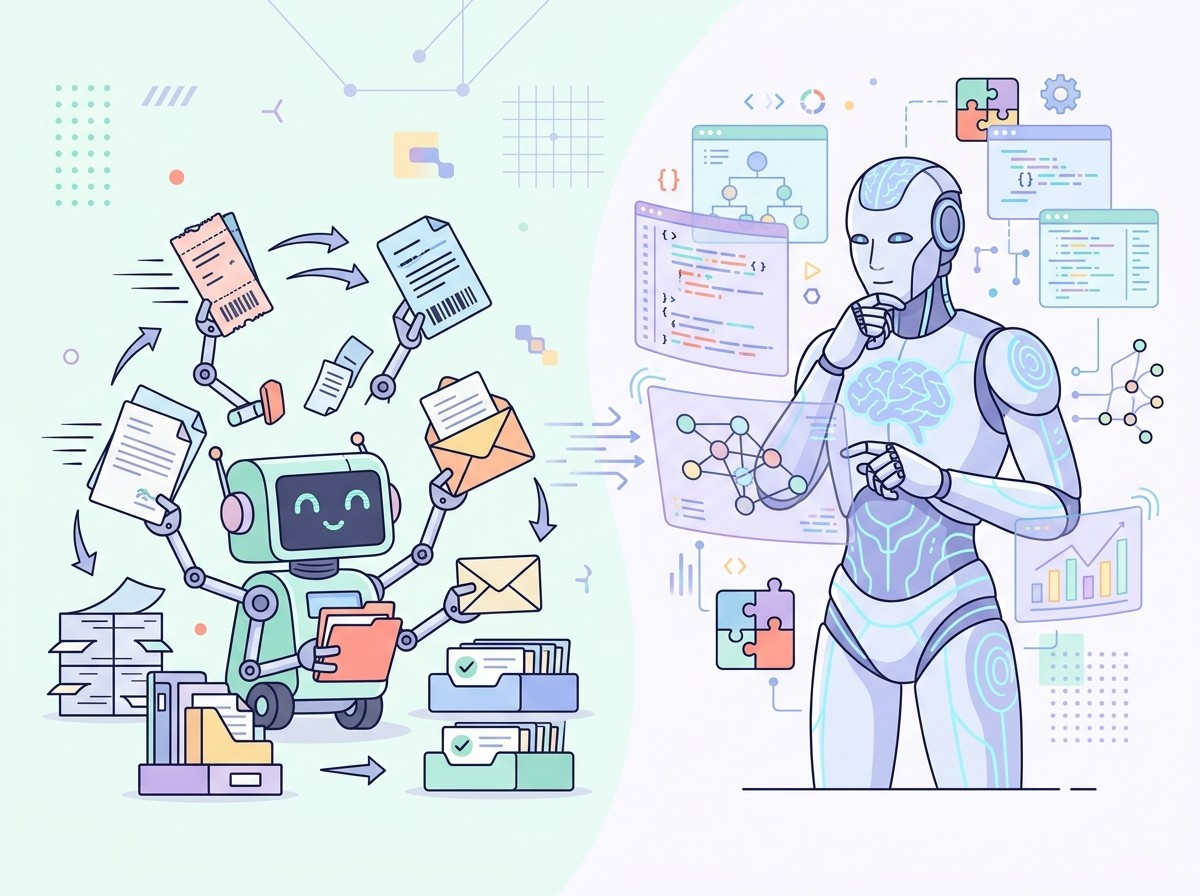
Anthropic positionne clairement son petit modèle comme un excellent exécutant au service de Sonnet 5.5 ou d’Opus 5.5. Le modèle plus puissant joue le rôle de chef de projet et d’orchestrateur. Haiku 5.5 traite les lots répétitifs. Cognition a déjà intégré cette approche dans son agent de code Devin, en utilisant Haiku comme assistant d’Opus 5.5.
Dans les workflows multi-agents, ce sont souvent les sous-agents qui consomment le plus de tokens. Remplacer ces sous-agents par Haiku 5.5 peut générer les économies les plus visibles de toute l’architecture.
Agents navigateur et pilotage d’ordinateur
Anthropic revendique un score de 72,4 % sur OSWorld 2.1 (sous-ensemble hors ligne), contre 15,7 % pour Haiku 4.5 et 83,9 % pour Sonnet 5.5. Ces chiffres n’ont pas encore été vérifiés par des organismes indépendants, mais ils ouvrent des perspectives concrètes : relevé de prix concurrents, contrôle qualité de pages produit, saisie dans un back-office sans API… Ces automatisations deviennent abordables à grande échelle, à condition bien sûr de respecter les conditions d’utilisation des sites concernés.
Les tâches à éviter absolument avec Claude Haiku 5.5
Faut-il tout basculer sur Haiku 5.5 ? La réponse est clairement non. Anthropic le reconnaît lui-même : Sonnet 5.5 et Opus 5.5 restent les meilleurs modèles pour le code agentique et les tâches longues qui demandent un raisonnement complexe. Les analyses indépendantes ajoutent plusieurs zones de risque supplémentaires.
Les réponses factuelles sans source fournie
Avec seulement 36 % de bonnes réponses sur AA-Omniscience, Haiku 5.5 n’est pas un modèle à interroger « à froid » sur un fait de marché, une réglementation ou une fiche technique. Pour ce type de demande, deux options s’imposent : fournir le document de référence dans le prompt, ou passer par un modèle plus lourd connecté à la recherche web.
Le code agentique complexe
Sur Terminal-Bench 4.0, Haiku 5.5 atteint 33 %, contre 0 % pour Haiku 4.5 et 13 % pour GPT-6 Luna. Le progrès est net, mais on reste loin des 70,6 % revendiqués par Anthropic pour Sonnet 5.5. Pour une refonte de thème WordPress, un script de migration ou un agent de code autonome, le développeur gagnera clairement du temps avec le grand modèle.
Les workflows SaaS automatisés (pour l’instant)
Haiku 5.5 obtient seulement 35 % sur AutomationBench-AA, loin des 53 à 60 % de ses concurrents directs. Artificial Analysis attribue cet écart à un bug de sécurité qui pousse le modèle à refuser trop souvent. Anthropic travaille à un correctif. En attendant, mieux vaut garder les automatisations critiques sur le modèle actuellement en production.
Les prompts de plus de 100 000 tokens
Comme évoqué plus haut, le tarif avantageux ne s’applique que sous 100 000 tokens de prompt. Au-delà, le coût est multiplié par cinq. Avant toute migration, analysez la distribution réelle de la taille de vos requêtes. Si une part notable dépasse déjà ce seuil, l’économie devient nettement moins intéressante.
L’effort maximal en production
Le score de 43 points a un prix caché. En effort maximal, Haiku 5.5 produit environ 162 000 tokens de sortie par tâche, soit trois fois plus que GPT-6 Luna. Passer de xhigh à max ne rapporte que 2 points pour 1,8 fois plus de tokens. Sur un flux de plusieurs milliers d’appels par jour, ce réglage ne se justifie presque jamais. Partez systématiquement de medium et ne montez que si vos tests internes le réclament.
Tableau de décision : Haiku 5.5 ou Sonnet / Opus 5.5 ?
Pour une équipe marketing, la répartition optimale est souvent la suivante : confier tout le travail préparatoire et répétitif à Haiku 5.5, et garder un modèle haut de gamme pour les livrables qui engagent la marque.
Voici un guide de décision simple :
Tri, classification, routage → Oui à Haiku 5.5 (effort low ou medium). Sonnet est surdimensionné.
Résumé de documents sous 100 000 tokens → Oui à Haiku 5.5. Réserver Sonnet aux synthèses à fort enjeu.
Extraction et Q&R sur documents fournis → Oui à Haiku 5.5. Passer à Sonnet si raisonnement croisé entre plusieurs sources.
Support client de premier niveau → Oui à Haiku 5.5 avec escalade prévue. Sonnet pour les cas complexes.
Sous-agent d’un workflow multi-agents → Oui à Haiku 5.5 sur les lots répétitifs. Sonnet ou Opus en orchestrateur.
Réponses factuelles sans source fournie → À éviter (36 % sur AA-Omniscience). Préférer un modèle plus lourd idéalement avec recherche web.
Code agentique complexe → À éviter (33 % sur Terminal-Bench 4.0). Oui à Sonnet ou Opus.
Workflows SaaS automatisés → Pas avant le correctif (35 % sur AutomationBench-AA). Oui à Sonnet ou Opus pour l’instant.
Analyse de très longs documents (plus de 100 000 tokens) → Tarif x5, à chiffrer au cas par cas. Comparer avec Sonnet en tenant compte du cache.
Comment tester Haiku 5.5 dans votre propre stack
Avant de faire un gros changement de modèle en production, la règle d’or reste inchangée : menez vos propres tests avec vos propres critères d’évaluation. Faites tourner Haiku 5.5 sur un échantillon représentatif de vos données réelles et comparez-le avec le modèle actuellement en place.
Quelques bonnes pratiques concrètes :
- Commencez toujours en effort medium et ne montez que si le gain de qualité est mesurable.
- Mesurez non seulement la qualité, mais aussi la latence et le coût réel par tâche.
- Vérifiez la distribution de la taille de vos prompts pour anticiper le seuil des 100 000 tokens.
- Testez le modèle en sous-agent d’un workflow multi-modèles plutôt que comme unique cerveau.
- Prévoyez toujours une escalade claire vers un modèle plus puissant pour les cas limites.
Les abonnés Max et Team d’Anthropic reçoivent désormais un crédit API mensuel de 100 à 500 $, ce qui permet de lancer des tests sans budget dédié immédiat. L’éditeur propose également des formations gratuites pour monter en compétence sur Claude.
Notre verdict : un exécutant redoutable, pas une source de vérité
Claude Haiku 5.5 offre actuellement l’un des meilleurs ratios score/prix de sa catégorie selon Artificial Analysis, à condition de l’utiliser comme exécutant et non comme source de vérité. Confiez-lui le tri, le résumé, l’extraction et le support de premier niveau en effort medium, avec la source dans le prompt et sous 100 000 tokens. Gardez Sonnet ou Opus pour le code complexe, les tâches marketing qui demandent un vrai raisonnement ou du goût (design, copywriting créatif), les réponses factuelles à froid sans sources, et vos automatisations SaaS critiques en attendant le correctif.
Dans un contexte où les volumes d’appels IA explosent, la capacité à répartir intelligemment la charge entre un modèle économique et un modèle premium devient un avantage concurrentiel réel. Haiku 5.5 n’est pas le modèle le plus intelligent du marché. C’est probablement l’un de ceux qui peuvent faire le plus économiser d’argent et de temps… à condition de bien choisir les missions qu’on lui confie.
Haiku 5.5 travaille bien sur l’information que vous lui fournissez, beaucoup moins sur celle qu’il est censé connaître de lui-même.
– Synthèse des benchmarks Artificial Analysis
Si votre équipe marketing, produit ou support traite déjà des milliers de documents, tickets ou fiches produits chaque mois, le moment est venu de tester concrètement ce petit modèle. Les économies potentielles sont trop importantes pour être ignorées, et les risques restent maîtrisables dès lors que l’on respecte les limites identifiées par les benchmarks indépendants.
La véritable intelligence, en 2026, ne consiste plus à utiliser le modèle le plus puissant pour tout. Elle consiste à utiliser le bon modèle pour chaque tâche. Claude Haiku 5.5 vient d’élargir considérablement le champ des possibles pour toutes les opérations répétitives, cadrées et à fort volume. À vous de jouer maintenant pour identifier celles qui, dans votre propre organisation, méritent d’être basculées en priorité.