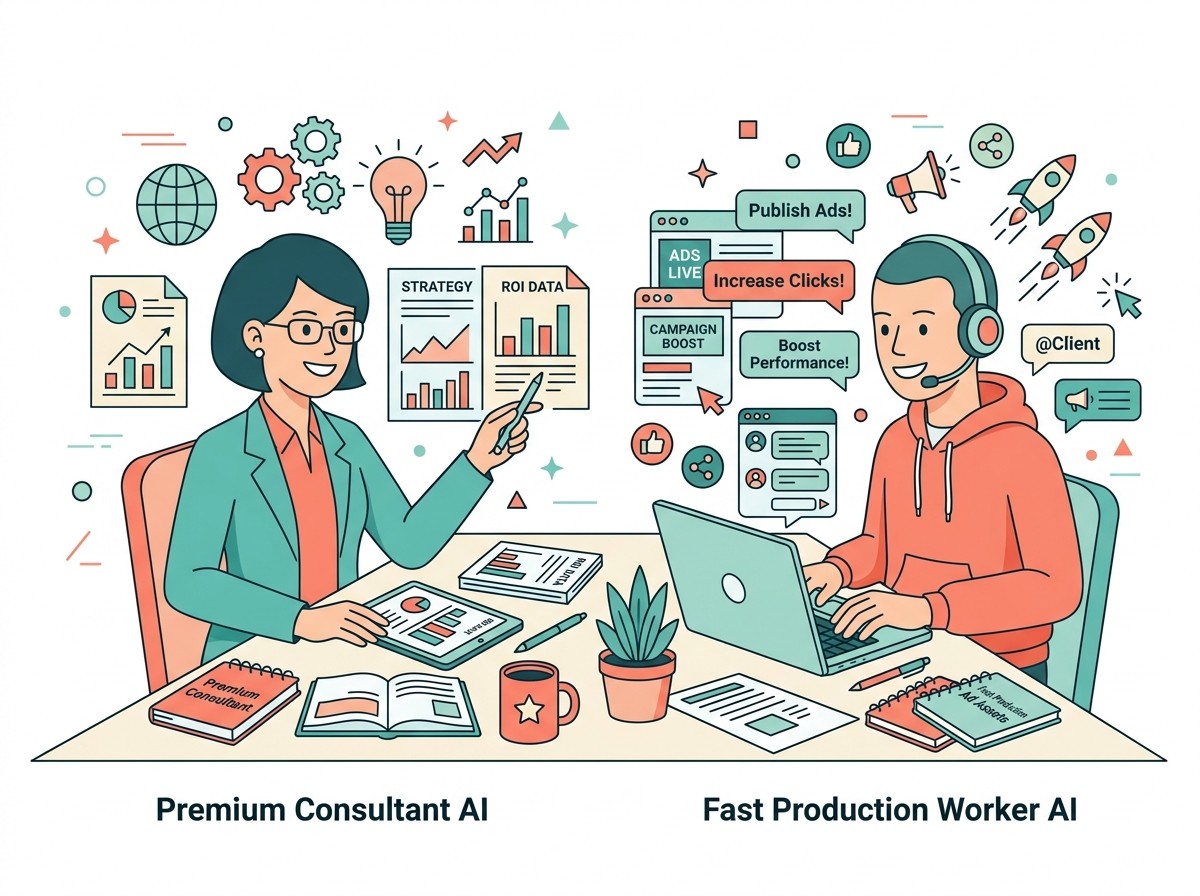

Deux nouveaux modèles débarquent presque le même jour, et déjà les équipes marketing se demandent lequel coller dans leur stack. Faut-il payer le consultant premium qui réfléchit plus longtemps, ou miser sur l’usine à volume qui répond en moins d’une seconde ? Fin septembre 2026, Anthropic pousse Claude Opus 5.5 comme son fer de lance. OpenAI, de son côté, sort GPT-6 Sol comme une version plus rapide et moins chère de GPT-6 Astra. Les scores d’intelligence, les grilles tarifaires et les promesses éditoriales ne racontent pas la même histoire. Ce qui compte pour un marketeur, c’est autre chose : le brief respecté, le chiffre qui ne sort pas de nulle part, le workflow Zapier qui ne casse pas à la troisième étape, et la facture API qui ne explose pas dès que l’on génère trois cents fiches produits.
La comparaison n’est pas un match de boxe entre deux poids lourds identiques. Opus 5.5 vise le haut du panier. Sol se positionne volontairement en dessous d’Astra, avec un petit frère encore plus agressif sur le prix, GPT-6 Luna. Lire les communiqués côte à côte sans regarder le niveau d’effort, le coût par tâche réelle et le type de livrable, c’est se tromper de débat. Voici une lecture terrain, orientée acquisition, contenu, CRM et production, pour décider où placer chaque modèle plutôt que de les opposer bêtement.
Ce Que Les Chiffres Disent Vraiment
Artificial Analysis a passé les deux modèles au même tamis : l’Intelligence Index version 4.3.2, qui agrège dix évaluations proches du travail de bureau. Documents longs, workflows métier, tâches d’analyse. L’indice n’est pas un quiz de culture générale. Il mesure ce qu’une équipe marketing demande vraiment : extraire, relier, rédiger, décider. Et surtout, il le fait à plusieurs niveaux d’effort, c’est-à-dire selon le temps de réflexion laissé au modèle avant de répondre.
Au réglage faible, Opus 5.5 obtient 42 contre 34 pour Sol. Au réglage moyen, 51 contre 40. En élevé, 54 contre 43. En très élevé, 56 contre 44. Au maximum, 58 contre 48. L’écart tient : huit à douze points à chaque cran. Sur le papier, le verdict semble simple. Dans la vraie vie, le budget API n’est jamais « sur le papier ».
Le coût moyen par tâche de l’indice raconte l’autre moitié de l’histoire. Opus 5.5 revient à 0,55 $ en effort faible, 1,34 $ en moyen, 1,82 $ en élevé, 3,46 $ en très élevé et 5,98 $ au maximum. Sol, lui, reste à 0,13 $, 0,25 $, 0,37 $, 0,53 $ puis 1,06 $. Traduction : quatre à six fois et demie plus cher par tâche pour Opus, parce qu’il consomme aussi davantage de tokens pour réfléchir. Le rapport officiel des grilles (4 $ / 20 $ contre 2 $ / 10 $ par million de tokens) sous-estime l’écart réel dès que l’on sort du simple calcul entrée / sortie.
Opus 5.5 en réglage moyen fait mieux que Sol poussé au maximum, pour un budget proche. Comparez-les à budget égal, pas au même cran d’effort.
– Lecture des données Artificial Analysis, septembre 2026
C’est le point que trop d’équipes ratent. Elles testent les deux modèles « à fond » puis concluent que le plus intelligent gagne. Elles oublient que Sol au maximum (48 points pour 1,06 $) reste derrière Opus en moyen (51 points pour 1,34 $). Si vous payez à l’usage, le bon test n’est pas « qui a le plus gros score », c’est « qui livre le meilleur résultat pour mon enveloppe mensuelle ».
Deux Catégories, Pas Un Seul Ring
Anthropic présente Opus 5.5 comme son modèle de pointe, au niveau de Claude Fable 5.1 sur la plupart des tâches. OpenAI assume un autre récit : Sol n’est pas le roi de la maison. Le haut de gamme reste GPT-6 Astra, sorti plus tôt dans le mois. Sol est la déclinaison plus rapide, plus abordable. Luna descend encore le prix à 0,10 $ / 0,50 $ par million de tokens. Comparer Opus 5.5 à Sol comme si l’on comparait deux fleurons, c’est déjà biaiser le match.
Cette architecture de gamme change la stratégie d’achat. Chez Anthropic, vous prenez le meilleur disponible et vous dosez l’effort. Chez OpenAI, vous pouvez empiler Astra pour la stratégie, Sol pour la production, Luna pour le brute-force. Les équipes qui n’ont qu’un seul abonnement auront un choix plus tranché. Celles qui peuvent mixer les deux API construiront un routing plus fin : le livrable qui engage la marque d’un côté, le volume qui remplit le calendrier de l’autre.
Le contexte de fenêtre joue aussi. Opus 5.5 avale environ un million de tokens, soit près de 1 500 pages A4. Sol tient 872 000 tokens, autour de 1 300 pages. Pour charger un lot d’études concurrentielles, les deux suffisent largement. L’écart n’est pas un argument décisif sauf si vous colliez des bases documentaires monstrueuses en une seule passe. En marketing B2B, le goulot d’étranglement reste rarement la fenêtre. C’est la qualité de la source, le prompt de cadrage et le contrôle humain en sortie.
Rédaction Et Charte Éditoriale : Qui Tient Le Brief
Les deux éditeurs martèlent le même progrès stylistique : phrases plus claires, moins de jargon, réponses plus courtes. Sur un article de blog ou une landing, cela se sent. On sort enfin des textes qui empilent les adverbes pour masquer le vide. Reste la question qui brûle les content managers : le modèle suit-il votre charte, pas une charte générique de labo ?
Anthropic insiste sur la capacité d’Opus 5.5 à respecter des règles d’écriture fournies en amont. Ton, longueur, interdits lexicaux, structure Hn, mentions légales, manière de parler d’un produit. Si votre équipe travaille avec des briefs serrés — un SaaS B2B qui refuse le mot « révolutionnaire », une marque luxe qui impose un rythme, un média qui bannit les anglicismes inutiles — cet argument a du poids. Sol n’est pas « hors sujet » pour autant. Il gagne dès que le cadre est simple et que le volume explose : déclinaisons d’accroches, variantes d’objets d’email, réécritures de fiches catalogue.
Le seul protocole honnête reste le test face à face. Prenez cinq briefs réels. Même persona, même offre, même contrainte de mots. Faites produire les deux modèles au même budget tokens, pas au même réglage d’effort. Faites relire à un rédacteur senior qui ne sait pas qui a écrit quoi. Notez trois critères seulement : fidélité au brief, voix de marque, faits vérifiables. Vous obtiendrez plus de vérité en deux heures que dans dix tableaux de benchmark.
Pour un calendrier éditorial mixte, le schéma qui tient souvent est le suivant. Opus 5.5 pose l’angle, l’architecture et le premier jet stratégique. Sol décline les versions sociales, les extraits newsletter internes à l’équipe, les meta descriptions et les A/B d’accroches. Ce n’est pas une hiérarchie morale. C’est une allocation de coût. Le consultant ne rédige pas les 80 variations d’annonce. L’équipe de production ne signe pas seule l’étude qui part chez un client.
Veille, Études Et Chiffres : La Zone Rouge Des Hallucinations
La veille est le terrain où une IA brillante devient dangereuse. Un rapport concurrentiel avec un chiffre inventé circule plus vite qu’une correction. Anthropic a publié un test interne : Opus 5.5 aurait rédigé 16 rapports sur 18 sans aucun chiffre ni citation inventés, à partir de sources difficiles à trouver. Claude Fable 5.1 et Opus 5 n’auraient réussi l’exercice dans aucune tentative. OpenAI affirme de son côté que Sol commet environ deux fois moins d’erreurs factuelles que son prédécesseur, toujours sur une évaluation interne.
Deux mises en garde s’imposent. D’abord, ce sont des tests d’éditeurs, pas un laboratoire indépendant commun. Ensuite, « moins d’erreurs » n’égale pas « zéro erreur ». Pour une synthèse chiffrée destinée à un COMEX, Opus 5.5 reste le choix le plus prudent d’après les éléments disponibles. Pour un tri quotidien de signaux faibles — titres, extraits, classification de sources — Sol peut absorber le flux à moindre coût, à condition qu’un humain valide les chiffres qui partent en slide.
La fenêtre longue aide vraiment ici. Charger dix études Fevad, cinq rapports concurrentiels et un export CRM dans la même conversation change la nature du travail. Le modèle n’est plus un générateur de paragraphes. Il devient un analyste de corpus. Opus 5.5, avec son million de tokens, offre une marge de confort. Sol, à 872 000, n’est pas ridicule. La différence se joue plus sur la discipline de citation que sur les cent cinquante pages d’écart.
Un process sain ressemble à ceci. Sources d’abord, modèle ensuite. Vous collez des PDF et des URL contrôlées, vous interdisez d’inventer une statistique absente du lot, vous exigez des extraits entre guillemets avec localisation. Puis vous faites relire les chiffres par quelqu’un qui a déjà ouvert les documents. Sans cette boucle, le modèle le plus intelligent du marché reste un risque réputationnel.
Automatisation Crm, Emailing Et Reporting
AutomationBench, conçu par Zapier, force l’IA à exécuter des scénarios complets sur 47 outils : ventes, marketing, support, finance. C’est l’un des rares bancs d’essai où les deux camps publient un score. Opus 5.5 réussit 40,0 % des scénarios. GPT-6 Sol en effort xhigh atteint 33,2 % pour 0,27 $ par tâche. Opus 5, en repère, restait à 26,9 %. La progression est nette. Elle n’est pas magique.
Lisez le chiffre inverse : même le meilleur score laisse plus de la moitié des scénarios en échec. Aucun des deux modèles ne peut tourner sans contrôle humain en fin de chaîne. Si votre stack relie CRM, outil d’emailing, tableur et Slack, prévoyez une validation, un log d’erreur et un fallback. L’automatisation « autonome » reste un argument de keynote, pas un standard opérationnel en 2026.
Quand la précision prime — scoring de leads ambigu, rédaction d’un email de relance sensible, reporting qui alimente un board — Opus 5.5 justifie son surcoût. Quand le scénario est cadré, répétitif, avec des champs structurés et peu d’exceptions, Sol tient la charge à un prix nettement plus bas. Comparer les deux au même niveau d’effort n’a pas de sens. Comparez un Opus moyen à un Sol très élevé. Vous rapprochez alors intelligence et budget.
Les équipes les plus matures ne choisissent pas un modèle unique pour « l’automation ». Elles routent. Une intention complexe part vers Opus. Une mise à jour de champ, une classification de verbatim, une génération de ligne de reporting partent vers Sol ou Luna. Le gain n’est pas seulement financier. Il évite d’user le modèle cher sur des tâches où l’intelligence supplémentaire n’apporte rien de mesurable.
Volume, Vitesse Et Assistants En Temps Réel
Fiches produits, déclinaisons Google Ads et Meta, réponses de chatbot, classement de verbatims : ici, les derniers points d’intelligence pèsent moins que la latence et le coût unitaire. Artificial Analysis situe Sol entre 104 et 125 tokens par seconde, contre 75 à 92 pour Opus 5.5. Sur le temps de réponse, l’écart se creuse encore. Sol peut descendre sous la seconde en mode sans raisonnement. Opus 5.5, qui ne peut plus couper sa phase de réflexion, reste au mieux à 4,79 secondes.
Pour un assistant face client, le choix est presque mécanique. Quatre secondes d’attente, c’est une éternité dans un chat e-commerce. Une seconde, c’est un échange fluide. Sol (et davantage Luna si le volume explose) devient l’outil de file d’attente. Opus 5.5 peut préparer les bascules complexes — escalade, argumentaire juridique, réponse à un avis explosif — mais il n’a pas vocation à tenir le front office 24 heures sur 24.
Le même raisonnement s’applique aux catalogues. Générer 2 000 fiches avec variantes de titre, meta et bullets n’exige pas le modèle le plus fin du marché. Il exige de la consistance, un schéma JSON stable et un prix prévisible. Sol coche ces cases. Réservez Opus aux fiches « phares », aux pages catégorie stratégiques, aux textes qui portent une promesse de marque délicate.
La vitesse n’est pas qu’un confort utilisateur. Elle change le design des tests. Avec Sol, vous itérez dix accroches pendant qu’Opus en produit trois. En acquisition payante, cette densité d’itération vaut souvent plus que deux points d’indice. Encore faut-il un humain pour tuer les variantes hors charte. La cadence sans garde-fou produit surtout du bruit média.
Sites, Landing Pages Et Intégrations Techniques
Anthropic place Opus 5.5 en tête de ses tests de développement. Lovable, plateforme de création d’apps, rapporte des builds bouclés avec un tiers à la moitié d’étapes en moins. OpenAI répond que Sol égale Claude Fable 5.1 sur FrontierCode, un test qui juge si le code est assez propre pour être intégré, et cela pour un coût bien inférieur.
Pour une landing simple — hero, preuve sociale, formulaire, FAQ — Sol suffit souvent. Pour un parcours multi-étapes, un calculateur, une intégration CRM capricieuse ou un design system déjà chargé, Opus 5.5 réduit les allers-retours. L’arbitrage n’est pas « code versus no-code ». C’est complexité versus répétition. Une page unique très contrainte vaut le modèle premium. Une série de pages événementielles cadencées vaut le modèle intermédiaire.
Les marketeurs qui pilotent aussi un peu de front doivent rester lucides. Un score de benchmark de code ne garantit pas une page qui convertit. Le modèle peut produire un composant élégant et rater le message d’offre. Séparez les rôles : brief conversion d’un côté, implémentation de l’autre. Faites relire le copy par quelqu’un qui vend, le code par quelqu’un qui déploie. L’IA accélère les deux, elle ne fusionne pas les responsabilités.
Prix, Accès Et Limites Concrètes
La grille officielle est simple à mémoriser. Claude Opus 5.5 : 4 $ en entrée et 20 $ en sortie par million de tokens. GPT-6 Sol : 2 $ et 10 $. Le positionnement aussi. Opus est le modèle de pointe d’Anthropic. Sol est intermédiaire, sous Astra. Fenêtre : un million de tokens contre 872 000. Vitesse d’écriture : 75–92 tokens/s contre 104–125. Accès : Claude, API, AWS, Google Cloud, Azure d’un côté ; ChatGPT Work et Codex sur offres payantes plus l’API de l’autre.
Un détail opérationnel change le calendrier d’adoption. Si Opus 5.5 est déjà disponible sur Claude Code et Claude.ai pour ceux qui y ont accès, Sol demandera encore un peu de patience côté interface grand public. Il est annoncé pour les abonnés Plus, Pro, Business, Enterprise et Edu, mais pas encore dans l’interface Chat classique. Vos tests API peuvent donc précéder l’usage quotidien des équipes non techniques.
Les plafonds de tokens et les files d’attente resteront des variables cachées du coût réel. Un modèle moins cher qui throttle aux heures de pointe peut coûter plus cher en temps humain qu’un modèle premium fluide. Intégrez la fiabilité d’accès dans votre scorecard, pas seulement le tarif public.
Comment Choisir Sans Se Tromper De Combat
Posez d’abord la nature du livrable. Est-ce un document qui engage votre crédibilité ? Étude, recommandation stratégique, webdesign critique, automatisation qui touche de l’argent ou des données clients. Dans ce cas, Opus 5.5 joue le rôle du consultant senior. Est-ce une tâche précise, cadencée, mesurable au volume ? Production d’annonces, assistant temps réel, classement, déclinaisons. Sol joue alors le rôle de l’équipe de production.
Posez ensuite le budget. Si votre enveloppe API est serrée, Sol au maximum peut rivaliser avec Opus en moyen sur le rapport qualité-prix de l’indice. Si vous avez de la marge et que l’erreur factuelle coûte cher — un dossier client, une prise de parole publique — le surcoût d’Opus est une police d’assurance, pas un caprice.
Posez enfin le niveau de contrôle humain. Plus le taux d’échec d’AutomationBench devrait vous calmer. Quarante pour cent de réussite, c’est un copilote, pas un pilote automatique. Construisez des revues courtes, des checklists de faits, des tests A/B de prompts. Le modèle n’absout pas la gouvernance.
- Opus 5.5 : veille sensible, études chiffrées, briefs stricts, automations critiques, builds complexes.
- GPT-6 Sol : volume, chat temps réel, déclinaisons ads, catalogues, scénarios CRM simples.
- GPT-6 Luna : brute-force ultra low cost quand la qualité « assez bonne » suffit.
- GPT-6 Astra : à garder en tête si vous voulez le haut de gamme OpenAI, pas Sol.
- Règle d’or : comparer à budget égal, jamais au même cran d’effort seulement.
Un Plan De Test Sur Quinze Jours
Jours 1 et 2 : inventaire. Listez dix tâches réelles de la semaine dernière. Qualifiez chacune selon trois axes : risque réputationnel, volume, besoin de sources. Vous verrez tout de suite que tout n’a pas besoin du même cerveau.
Jours 3 à 7 : bak-à-bak. Cinq briefs rédaction, deux synthèses documentaires, deux scénarios d’automation, un lot de cinquante variantes ads. Même données d’entrée. Budget tokens plafonné par tâche. Notation aveugle par un pair.
Jours 8 à 10 : mesure du coût réel. Ne vous fiez pas au tarif million de tokens. Ajoutez le temps de relecture, les retries, les tâches ratées. Un modèle « bon marché » qui impose trois passes humaines n’est plus bon marché.
Jours 11 à 13 : routing. Écrivez une règle simple dans votre outil d’orchestration. Si la tâche contient « chiffre », « client stratégique » ou « juridique », envoyer vers Opus. Si elle contient « variante », « classification » ou « chatbot », envoyer vers Sol.
Jours 14 et 15 : revue. Gardez ce qui a réduit le temps de cycle sans augmenter les incidents qualité. Abandonnez le reste. Un stack IA n’est pas une collection de logos. C’est une série de paris mesurés.
Pièges Fréquents Dans Les Équipes Marketing
Le premier piège est le fétichisme du score. Cinquante-huit contre quarante-huit impressionne en réunion. Cela ne dit rien d’une landing qui convertit à 2,1 % plutôt qu’à 1,8 %. Ancrez toujours le benchmark externe à un KPI interne.
Le deuxième piège est l’uniformité. Une seule clé API, un seul modèle, un seul prompt universel. C’est confortable. C’est aussi le moyen le plus sûr de payer trop cher le volume et pas assez cher la stratégie — ou l’inverse.
Le troisième piège est la confiance dans les évaluations internes des éditeurs. Elles donnent une direction. Elles ne remplacent pas vos corpus, votre jargon sectoriel, vos contraintes RGPD, vos outils métier tordus. Un modèle qui brille sur AutomationBench peut trébucher sur votre instance HubSpot mal nommée.
Le quatrième piège est d’oublier Astra et Luna. Sol n’est pas « OpenAI ». C’est une ligne de la gamme. Si votre besoin est le sommet de l’intelligence côté OpenAI, vous ne discutez pas de Sol. Si votre besoin est le coût plancher, vous ne discutez pas d’Opus.
Ce Que Cela Change Pour Une Startup Et Pour Un Groupe
Dans une startup, le cash tokens compte autant que le cash ads. Sol, éventuellement Luna, absorbe le quotidien. Opus 5.5 intervient sur le pitch deck, l’étude de marché investisseur, la page pricing, le workflow qui touche la facturation. Le ratio 80 / 20 n’est pas une formule magique, mais il évite de brûler le runway sur de la génération de posts.
Dans un groupe, le sujet devient gouvernance. Qui a le droit d’envoyer des données clients dans quel modèle, chez quel cloud, avec quelle rétention. Opus disponible via AWS, Google Cloud et Azure peut coller à une politique d’achat déjà en place. Sol via l’API OpenAI aussi, mais les circuits d’approbation ne sont pas les mêmes. Anticipez la paperasse. Le modèle le plus malin du monde n’entre pas dans un SI sans ticket.
Les agences, elles, doivent facturer la valeur, pas le token. Si vous vendez une recommandation stratégique produite par Opus, le client paie l’analyse. Si vous vendez 200 déclinaisons produites par Sol, le client paie la cadence. Mélanger les deux dans une même ligne « création IA » brouille le pricing et attire les mauvaises conversations sur le coût de revient.
Qualité De Source, Prompts Et Contrôle : Le Vrai Différenciateur
Aucun des deux modèles n’efface la médiocrité d’un brief. « Fais-moi un article SEO » produira un texte interchangeable, que le score soit à 48 ou à 58. Un brief qui fixe l’angle, l’objection client, la preuve chiffrée autorisée et le mot interdit produit déjà 70 % du résultat. L’IA amplifie le cadrage. Elle ne le crée pas.
Construisez des bibliothèques de contextes : charte, exemples aimés, exemples détestés, lexique produit, FAQ juridique. Injectez-les. Mesurez la dérive. Un modèle qui « oublie » une règle après trois tours de conversation n’est pas assez fiable pour le sans supervision, quel que soit l’éditeur.
Documentez les échecs. Quand une automation casse, notez l’outil, le message d’erreur, le prompt. Quand une synthèse invente un chiffre, archivez le passage. Ces journaux valent plus qu’un indice public pour votre prochaine décision d’achat.
Verdict Terrain Pour Les Pros Du Marketing
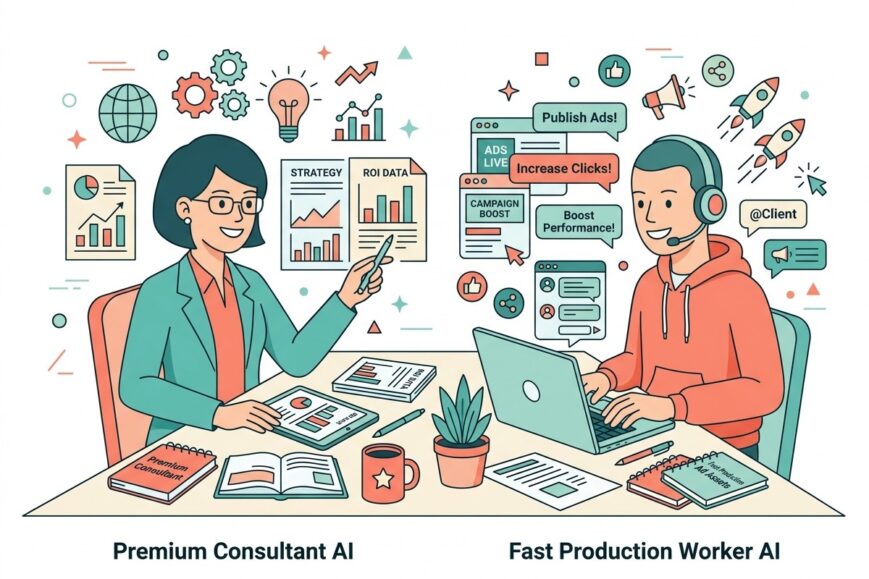
Opus 5.5 est le consultant senior. On le réserve aux livrables qui engagent la crédibilité : études, recommandations, designs sensibles, automatisations critiques. GPT-6 Sol est l’équipe de production : moins chère, plus rapide, très efficace dès que la tâche est cadrée. Pour la plupart des organisations marketing, les deux ont une place, à condition d’arrêter de les juger comme s’ils jouaient dans la même catégorie.
Le haut de gamme OpenAI s’appelle Astra, pas Sol. Le low cost s’appelle Luna. Opus occupe le sommet chez Anthropic et le paie. Si vous ne retenez qu’une phrase : ne comparez jamais les deux au même réglage d’effort. Comparez-les à budget égal, sur vos briefs, avec un humain à la fin de la chaîne. C’est moins glamour qu’un classement. C’est la seule méthode qui protège à la fois la marque et la trésorerie.
Les prochains mois diront si l’écart d’intelligence se resserre ou si le prix par tâche continue de dicter les stacks. En attendant, construisez un routing sobre, mesurez le coût fully loaded, et gardez le droit de changer d’avis. Les modèles bougent vite. Vos process de décision, eux, peuvent rester stables.