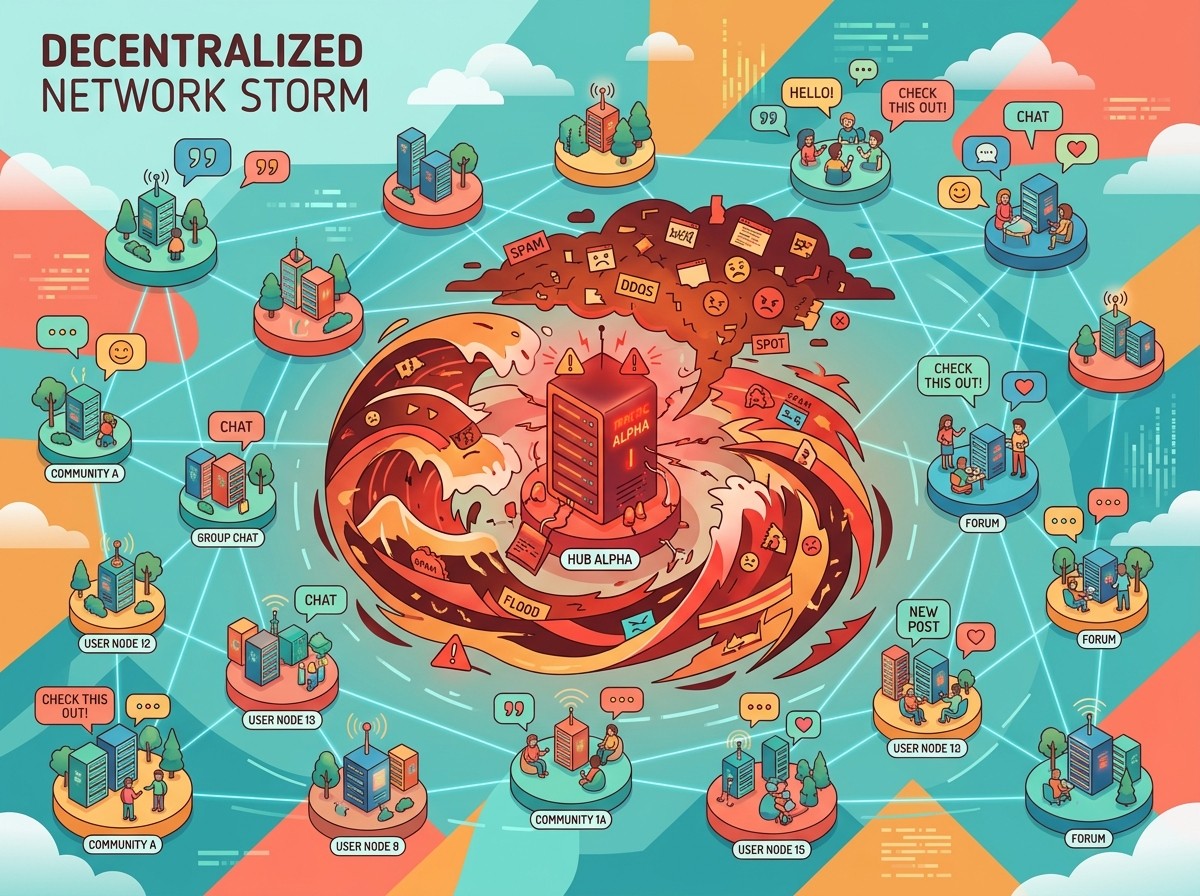

Et si le réseau sur lequel vous publiez chaque matin disparaissait pendant deux heures, sans que vos abonnés sur les autres serveurs ne s’en aperçoivent ? C’est précisément ce qui s’est joué un lundi d’avril 2026 autour de l’instance phare de Mastodon. Pendant que des millions de requêtes malveillantes saturaient mastodon.social, une grande partie du reste du Fediverse continuait de lire, répondre et partager comme si de rien n’était. Pour une équipe marketing, un fondateur de startup ou un responsable de communauté, l’épisode n’est pas une simple note de cybersécurité : c’est un révélateur sur la dépendance à un point d’entrée unique, sur la promesse réelle de la décentralisation, et sur la façon dont une panne ciblée peut fausser la lecture de vos performances digitales.
Le récit rapporté par TechCrunch est net. Le serveur officiel du logiciel social décentralisé a été frappé par une attaque par déni de service distribué. Le site est devenu inutilisable par moments. Des messages d’erreur ont remplacé le fil. Un bandeau d’incident a occupé l’écran. Vers 7 heures du matin, heure de l’Est, l’équipe indiquait qu’elle enquêtait. Vers 9 h 05, une contre-mesure était en place et l’accès revenait, avec un avertissement clair : l’attaque n’était pas terminée, et une instabilité pouvait persister. Interrogée, l’organisation a confirmé que les millions de requêtes observées correspondaient au schéma classique d’un DDoS, que seule l’instance mastodon.social était visée à ce stade, et que le rétablissement s’était joué en quelques heures.
Ce calendrier court ne doit pas rassurer trop vite. Deux heures d’indisponibilité sur une instance très visible, c’est une matinée entière de publications ratées, de liens cassés dans une newsletter déjà partie, de réponses clients laissées en suspens, et de captures d’écran qui circulent plus vite que le correctif. Le contexte alourdit encore la lecture. Quelques jours plus tôt, Bluesky sortait à peine d’une série d’interruptions liées à un DDoS prolongé. Au 17 avril, le service était stable depuis la veille au soir, heure du Pacifique, tout en indiquant que l’attaque elle-même n’était pas close. Deux réseaux souvent présentés comme des alternatives aux plateformes centralisées se retrouvent donc, à quelques jours d’intervalle, sous le même type de pression. La différence de architecture change la portée du choc. Elle ne l’annule pas.
Ce que l’on sait vraiment de l’incident du lundi
Il faut d’abord séparer les faits établis des interprétations tentantes. L’instance concernée est mastodon.social, le serveur officiel associé au logiciel Mastodon, pas l’ensemble des serveurs qui parlent le même protocole. L’incident a été qualifié de attaque par déni de service distribué. Le volume évoqué se compte en millions de requêtes malveillantes. L’effet visible côté utilisateur a été une inaccessibilité partielle ou totale, avec erreurs et écran d’incident. La parade a rendu le site de nouveau accessible en milieu de matinée, heure de l’Est, sans promesse d’un retour parfaitement lisse tant que le flux hostile continuait.
Autre point décisif : il ne s’agit pas, d’après les éléments publics, d’une intrusion destinée à voler des données. Un DDoS cherche à saturer. Il n’ouvre pas, en lui-même, les boîtes de messages, les fichiers médias ou les jetons d’accès. Cette distinction compte pour une marque. Une panne de disponibilité abîme le service et parfois la confiance. Une fuite de données déclenche un tout autre régime : notification, analyse juridique, communication de crise, parfois sanction. Confondre les deux dans un post trop rapide est une erreur classique. Le bon réflexe, le matin d’un incident, est de dire ce que l’on observe, pas ce que l’on imagine.
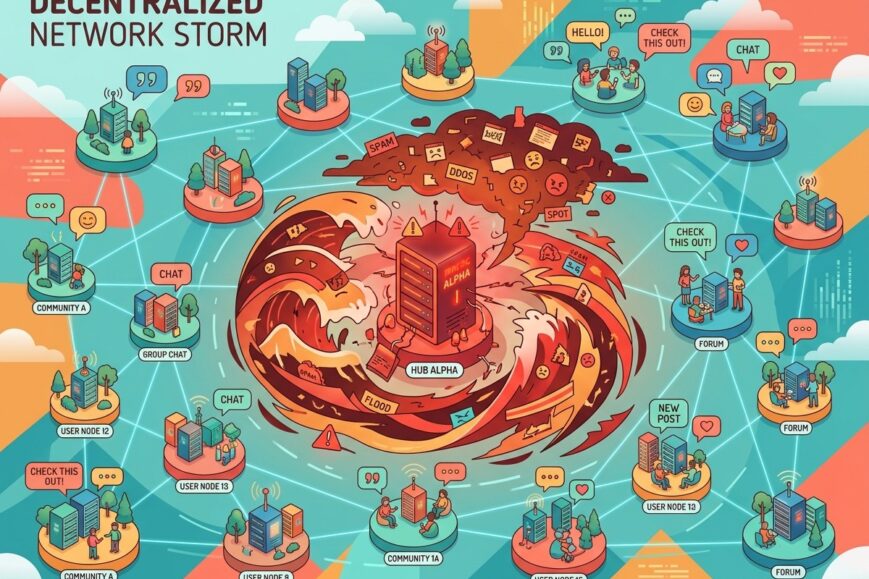
Andy Piper, responsable de la communication de Mastodon, a formulé l’argument que beaucoup de défenseurs du Fediverse attendaient. La nature décentralisée du réseau a joué ici comme un avantage concret. Les personnes dont le compte vivait sur un autre serveur Mastodon, ou sur un autre service du Fediverse, n’ont en général rien vu. Elles ont continué à lire et à publier. L’indisponibilité est restée, pour elles, invisible. Cette phrase mérite d’être gardée telle quelle, parce qu’elle résume mieux qu’un schéma technique ce que la décentralisation promet vraiment : non pas l’invulnérabilité, mais le cantonnement du dommage.
C’est un cas où la nature décentralisée du Fediverse est un véritable avantage. Les utilisateurs ayant un compte sur d’autres serveurs Mastodon, ou sur n’importe quel autre serveur du Fediverse, n’ont pas été affectés, et dans la plupart des cas l’incident leur est resté invisible : ils ont pu accéder au réseau, lire et partager des messages comme d’habitude.
– Andy Piper, responsable de la communication de Mastodon
La citation est utile, à condition de ne pas la transformer en slogan marketing. Elle décrit une propriété d’architecture dans un incident précis. Elle ne dit pas que chaque petite instance est mieux protégée qu’un grand cloud. Elle ne dit pas que la modération, la découverte de contenus ou la monétisation deviennent plus simples. Elle dit qu’un coup porté à un nœud très visible n’éteint pas le graphe entier. Pour une audience business, c’est déjà une information opérationnelle de premier ordre.
Comment un DDoS met un service social à genoux sans voler quoi que ce soit
Une attaque par déni de service distribué consiste à envoyer vers un site ou une application une masse de trafic inutile, assez dense pour que les serveurs légitimes n’arrivent plus à répondre aux vraies visites. Le mot distributed indique que ce trafic part de nombreuses sources, souvent des machines compromises ou des services mal configurés, ce qui rend le filtrage plus délicat qu’avec une seule adresse IP agressive. L’objectif n’est pas l’exfiltration. L’objectif est l’indisponibilité, parfois la simple démonstration de force, parfois la diversion pendant qu’autre chose se joue ailleurs. Dans le cas décrit, rien ne permet d’affirmer un mobile au-delà du schéma d’attaque lui-même.
La puissance de ces campagnes a explosé. L’an dernier, Cloudflare a indiqué avoir atténué ce qu’elle présentait comme la plus grande attaque DDoS observée à cette date, avec un pic de 29,7 térabits par seconde. L’image donnée pour saisir l’échelle est parlante : l’équivalent du remplissage de milliers de disques durs de données chaque minute. Tous les incidents n’atteignent pas ce sommet. Mastodon n’a pas publié, dans les éléments relayés, un débit comparable. Le chiffre Cloudflare sert surtout de repère : le plafond technique des attaques a bougé, et les équipes qui protègent un service grand public ne peuvent plus raisonner avec les volumes d’il y a dix ans.
Sur un réseau social, la saturation ne se voit pas seulement comme une page blanche. Elle se voit dans les files d’attente de la fédération, dans les médias qui n’arrivent plus, dans les notifications en retard, dans les applications mobiles qui affichent une erreur vague. Un community manager peut croire à un bug de l’outil de planification. Un annonceur peut croire à une chute organique. Un fondateur peut croire à un problème de son propre serveur. D’où l’intérêt, dès qu’une instance majeure tousse, de vérifier la page de statut avant de réécrire sa stratégie du trimestre.
Les contre-mesures habituelles combinent filtrage en bordure de réseau, limitation de débit, défi aux clients suspects, mise en cache agressive des pages publiques et parfois déplacement du trafic vers un prestataire spécialisé. Mastodon a indiqué avoir déployé une parade et rétabli l’accès en quelques heures. Le détail technique de cette parade n’a pas été détaillé dans le compte rendu public, et il n’a pas à l’être pour qu’une marque en tire une leçon. La leçon porte sur le délai, pas sur le nom du filtre : entre le signalement vers 7 heures et l’accessibilité annoncée vers 9 h 05, il s’est écoulé une fenêtre assez longue pour casser une séquence de publication, assez courte pour éviter une journée morte.
Bluesky quelques jours plus tôt : le même symptôme, une autre carte
L’attaque contre Mastodon arrive dans un voisinage immédiat. Bluesky, autre réseau social décentralisé au sens protocolaire, venait de sortir d’interruptions qui avaient duré plusieurs jours. D’après le point du 17 avril, le DDoS continuait, mais le service était stable depuis le 16 avril à 21 heures, heure du Pacifique. Une mise à jour du jour de l’article sur Mastodon confirmait encore cette stabilité. Le parallèle est tentant. Il est aussi imparfait, et c’est précisément pour cela qu’il intéresse les équipes produit et communication.
Dans le cas de Bluesky, les personnes qui avaient déplacé leur compte vers d’autres fournisseurs compatibles avec le même protocole, comme Blacksky, n’ont pas subi le même choc. L’interopérabilité a joué le rôle de filet. On retrouve la même logique que chez Mastodon : le protocole survit à la panne d’un opérateur. La différence perçue par le public tient à la durée. Une attaque qui s’étire sur plusieurs jours change le comportement des utilisateurs. Ils cherchent un miroir, un compte secondaire, un canal de secours. Une attaque contenue en une matinée produit surtout de la frustration et des captures d’écran.
Pour une startup qui construit sur un protocole ouvert, ces deux épisodes posent la même question de positionnement. Vendez-vous la promesse « nous ne tomberons jamais », ou la promesse « si nous tombons, le réseau autour de vous continue » ? La seconde est plus honnête, plus difficile à expliquer en une slide, et beaucoup plus solide le jour où un status page passe au rouge. Les marques qui ont migré une partie de leur audience vers ces réseaux après des crises sur les grandes plateformes centralisées doivent intégrer ce vocabulaire. La décentralisation n’est pas un bouclier marketing. C’est une architecture de confinement.
Pourquoi l’instance la plus connue reste la cible la plus rentable
mastodon.social concentre la notoriété, une partie des comptes médias, des profils institutionnels et des nouveaux arrivants qui n’ont pas encore choisi une communauté thématique. Attaquer ce serveur, c’est attaquer l’adresse que les articles de presse citent, celle que les tutoriels recommandent par défaut, celle qui apparaît dans les captures. Le coût symbolique est supérieur au coût technique d’une petite instance de niche. Le récit public parle alors de « Mastodon en panne », alors que des milliers d’autres serveurs répondent normalement.
Ce décalage entre le nom du logiciel et le nom d’un serveur est une dette de pédagogie. Mastodon est un logiciel. mastodon.social est une instance parmi d’autres, opérée par l’organisation qui développe ce logiciel. Le Fediverse désigne l’ensemble des services qui échangent via des protocoles communs, au premier rang desquels ActivityPub. Une marque qui ouvre un compte « sur Mastodon » sans préciser l’instance parle en réalité d’un hébergeur. Le jour où cet hébergeur subit un DDoS, son silence est local. Le malentendu, lui, est global.
Les petites instances n’ont pas été visées dans cet épisode, selon les éléments communiqués. Cela ne les rend pas insignifiantes dans une stratégie de présence. Une association, un média, une école ou une marque peut opérer son propre serveur, rejoindre une instance thématique, ou rester sur le serveur officiel pour la simplicité. Chaque choix déplace le risque. L’instance maison vous expose à votre propre capacité d’administration. L’instance mutualisée vous expose aux décisions, aux files d’attente et aux incidents de l’opérateur. L’instance phare vous expose à la visibilité, donc aux attaques qui cherchent le retentissement.
Il y a aussi un effet de seuil économique. Protéger un service très fréquenté contre des volumes modernes de trafic indésirable coûte cher : bande passante, prestataires de mitigation, astreintes, tests. Les projets à but non lucratif et les logiciels libres vivent souvent avec des équipes réduites et des dons. Leur résilience dépend alors autant de l’architecture du réseau que du budget du nœud le plus célèbre. Une marque qui s’appuie sur ce nœud pour sa relation publique devrait considérer cette asymétrie comme un risque fournisseur, au même titre qu’une dépendance à un outil de planification ou à un hébergeur de newsletter.
Ce que voient vraiment les équipes marketing pendant la panne
Imaginons une équipe communication qui a calé, ce lundi-là, trois publications : une annonce produit, une réponse à un fil critique, un relais d’un partenaire. Si le compte vit sur mastodon.social, la séquence se brise. Le lien partagé dans une story ailleurs renvoie vers une erreur. Les personnes qui découvrent la marque ce matin-là concluent, à tort ou à raison, que le compte est abandonné. Celles qui suivent depuis une autre instance voient peut-être encore d’anciens messages, mais plus les nouveaux, le temps que la fédération rattrape son retard. Le tableau de bord du lendemain affichera un creux. Sans note d’incident, ce creux sera lu comme un échec de contenu.
C’est là que l’épisode devient un sujet de gestion des médias sociaux, pas seulement de sécurité. Les indicateurs d’une journée ne sont comparables aux autres jours que si le canal était disponible. Une baisse de réponses, d’amplifications ou de clics sortants peut être un artefact d’infrastructure. Les reportings hebdomadaires qui ignorent les status pages produisent de mauvaises décisions : changer un ton qui fonctionnait, couper un format, accuser un community manager. La discipline minimale consiste à annoter les jours d’incident dans l’outil d’analyse, avec l’heure de début, l’heure de rétablissement annoncé, et la source.
Il y a aussi l’effet miroir sur les autres plateformes. Quand un réseau alternatif tombe, une partie de l’audience revient mécaniquement vers les grands réseaux centralisés pour commenter la panne. Le sujet devient la panne. Les marques qui surjouent l’ironie, ou qui promettent trop vite que « chez nous tout va bien » sans vérifier leur propre instance, se trompent de conversation. Le ton juste est factuel : nous constatons une indisponibilité sur telle instance, nos autres canaux restent ouverts, nous republierons ici dès que le service répond. Cette phrase tient en quelques lignes. Elle évite le procès en opportunisme.
Les entreprises qui utilisent ces réseaux pour le support client ont un cas plus sérieux. Un ticket ouvert le matin, sans réponse à cause d’une erreur serveur, n’est pas un ticket ignoré. Il doit être repris par un canal de secours : e-mail, formulaire, autre réseau, téléphone. Documenter ce basculement avant l’incident vaut mieux que l’inventer dans le fil de discussion. Les startups qui n’ont qu’un compte social comme porte d’entrée du support découvrent, ces jours-là, qu’elles ont confondu présence et infrastructure.
La décentralisation comme continuité, pas comme argument publicitaire
Le mot décentralisation a beaucoup servi, ces dernières années, à habiller des pitchs. Dans l’incident Mastodon, il retrouve un sens opératoire. Le réseau n’est pas un seul site. C’est un ensemble de serveurs qui s’échangent des activités. Quand l’un d’eux ne répond plus, les autres ne s’arrêtent pas. Les abonnés distants peuvent même ne pas percevoir la coupure, comme l’a souligné Piper. Cette propriété intéresse quiconque a déjà vu une campagne entière dépendre d’une seule API, d’un seul compte publicitaire, d’un seul domaine.
Elle a pourtant des limites que le marketing a intérêt à nommer. La découverte de nouveaux publics reste plus difficile quand l’audience est fragmentée. La modération n’est pas uniforme : chaque instance a ses règles. Un partenariat avec un créateur peut buter sur le fait que son compte et le vôtre ne vivent pas au même endroit, avec des délais de fédération. Les outils de mesure sont moins standardisés que sur les régies des grandes plateformes. Autrement dit, le confinement du risque technique s’accompagne d’une dispersion du risque éditorial et analytique. Ce n’est pas un défaut caché. C’est le prix du modèle.
Les organisations qui veulent tirer parti de cet avantage sans en subir seulement les frottements peuvent raisonner en portefeuille. Un compte sur l’instance générale pour la notoriété. Un compte ou une présence sur une instance sectorielle pour la densité de conversation. Un canal propriétaire, site ou lettre d’information, qui ne dépend d’aucun des deux. Le DDoS du lundi ne invalide pas ce portefeuille. Il en montre l’ordre de priorité : le canal que vous ne contrôlez pas ne doit jamais être le seul endroit où votre preuve de vie existe.
On peut rapprocher cette logique de celle des places de marché et des boutiques en propre. Être présent sur une grande vitrine apporte du flux. Tenir son propre domaine apporte la continuité. Le Fediverse ajoute une troisième couche : des vitrines qui se parlent entre elles. Si la grande vitrine officielle clignote, les petites continuent d’exposer vos anciens messages et, dès que la fédération reprend, les nouveaux. Ce n’est pas instantané. C’est néanmoins très différent d’une plateforme unique dont la panne efface l’audience entière.
Ce que les startups du social et de l’outillage doivent en retenir
Plusieurs familles de jeunes entreprises sont concernées, au-delà des médias qui relatent l’incident. Celles qui construisent des clients, des outils de planification, des tableaux de bord d’écoute ou des agents de publication vers le Fediverse. Celles qui hébergent des instances pour des tiers. Celles qui vendent de la modération, de l’analytics ou de l’identité. Un matin de DDoS sur l’instance la plus citée, leurs utilisateurs ouvrent un ticket. La qualité de la réponse fait partie du produit.
Un bon outil ne se contente pas d’afficher « échec de publication ». Il distingue une erreur d’authentification, un rejet de contenu, un délai de fédération et une indisponibilité du serveur distant. Il conserve le brouillon. Il propose un nouvel essai. Il note l’heure. Il évite de compter la tentative ratée comme une publication envoyée dans les statistiques client. Ces détails paraissent mineurs jusqu’au jour où un directeur marketing demande pourquoi la campagne « n’a pas performé ». L’éditeur qui sait montrer la page de statut tierce et l’horodatage des erreurs gagne la conversation.
Les hébergeurs d’instances, eux, relisent leurs contrats et leurs pages de statut. Promettre un réseau social clé en main sans parler de mitigation DDoS, de sauvegardes et de délai de rétablissement, c’est vendre une salle sans issue de secours. Les clients entreprises demanderont de plus en plus trois choses : où sont les données, qui décide de la modération, que se passe-t-il si le domaine ne répond plus. L’épisode mastodon.social leur fournit un cas d’école récent, public, et relativement bien documenté dans sa chronologie.
Il y a enfin une leçon de communication produit. Bluesky et Mastodon n’ont pas le même logiciel, ni le même protocole, ni la même histoire. Les articles qui les empilent sous l’étiquette « alternatives décentralisées » rendent service à la pédagogie grand public et tort à la précision. Une startup qui se positionne sur l’un des deux écosystèmes a intérêt à expliquer ce qu’elle interopère vraiment. Le jour d’une panne voisine, cette phrase évite d’hériter d’un incident qui n’est pas le sien, ou au contraire de rater un incident qui l’est.
Hébergement, coût caché et dépendance à un nom de domaine
Un compte social semble immatériel. Il repose pourtant sur des machines, des certificats, un nom de domaine, une équipe d’astreinte et des contrats de transit. Quand ces couches tiennent, personne ne les voit. Quand elles saturent, elles deviennent le produit. Les entreprises qui migrent une communauté vers une instance tierce délèguent ces couches. Ce n’est pas une faute. C’est un choix qui doit figurer dans la cartographie des dépendances, à côté du CRM, de l’outil d’e-mailing et du prestataire de paiement.
Le coût d’une mitigation sérieuse explique en partie pourquoi les gros nœuds restent exposés dans le récit, même lorsqu’ils se rétablissent vite. Absorber un flux hostile moderne exige de la capacité en excès, ou un partenaire capable de l’absorber à la demande. Les projets financés par dons arbitrent en permanence entre nouvelles fonctions, modération et protection. Les entreprises qui bénéficient de ces communs numériques, en y installant leur vitrine, peuvent contribuer autrement que par un post de soutien : financement, relais sobre des pages de statut, refus de surinterpréter une panne.
La dépendance au nom est plus subtile. Beaucoup de liens anciens pointent vers mastodon.social. Un article de presse, une fiche partenaire, une signature d’e-mail. Si ce domaine répond mal pendant une fenêtre, ces liens deviennent des culs-de-sac temporaires. D’où l’intérêt, pour une marque, de privilégier aussi une page sur son propre site, qui résume le message et renvoie vers les profils. Le profil social distribue. Le domaine propre archive. Les deux ensemble limitent l’effet d’un DDoS qui ne vous cible même pas, mais qui cible l’endroit où vous avez posé votre enseigne.
Protocole ouvert et expérience utilisateur : le décalage à expliquer
ActivityPub et les protocoles voisins permettent à des logiciels différents d’échanger suivis, messages et réponses. C’est ce qui rend crédible la phrase selon laquelle le reste du réseau n’a pas vu l’incident. Mais l’expérience n’est pas celle d’un nuage unique. Un message peut mettre du temps à apparaître ailleurs. Une suppression peut se propager de façon inégale. Une pièce jointe peut échouer alors que le texte passe. Pendant et juste après une attaque, ces frottements s’amplifient. L’utilisateur non spécialiste les vit comme des bugs du produit, pas comme des propriétés d’un système fédéré sous stress.
Les équipes communication ont donc un travail de traduction. Inutile d’exiger du grand public qu’il distingue instance, logiciel et protocole avant le café. Utile, en revanche, d’avoir une phrase maison : notre compte est hébergé sur tel serveur ; si ce serveur est indisponible, retrouvez l’essentiel sur notre site. Les médias et les institutions, souvent présents sur l’instance officielle par simplicité, sont les premiers concernés. Leur audience mêle des habitués du Fediverse et des curieux arrivés par un lien de presse. Les seconds jugeront le média à l’aune de la page d’erreur.
Cette pédagogie rejoint un sujet plus large de communication digitale : la transparence sur la chaîne de diffusion. On indique déjà, parfois, qu’une publicité est une publicité. On peut indiquer, sans jargon, qu’un profil dépend d’un hébergeur tiers. Le jour de l’incident, cette mention ancienne évite l’impression d’improvisation. Elle transforme un écran rouge en événement attendu dans le scénario, plutôt qu’en rupture de confiance.
Grille de lecture pour les community managers
Face à un incident de ce type, la réaction utile tient en gestes simples. Ils ne remplacent pas une cellule de crise chez l’opérateur. Ils évitent qu’une équipe de marque aggrave le bruit.
Voici une liste de contrôles concrets, à adapter à la taille de l’organisation.
- Vérifier la page de statut de l’instance avant de modifier le calendrier éditorial ou d’accuser un outil interne.
- Noter l’heure de début perçue, l’heure du message d’enquête et l’heure du rétablissement annoncé, en précisant le fuseau.
- Ne pas attribuer l’incident à un vol de données si aucun élément public ne va dans ce sens.
- Republier les messages essentiels sur un canal que vous contrôlez, sans surjouer l’exclusivité.
- Prévenir le support client qu’une file sociale peut être muette pour une raison d’infrastructure.
- Annoter les analytics du jour afin de ne pas comparer ce creux à une semaine normale.
- Éviter les captures moqueuses : une partie de votre audience utilise peut-être encore ce serveur.
- Après coup, relire où pointent vos liens permanents : domaine propre, instance officielle, instance thématique.
Cette grille ne demande pas d’expertise en mitigation. Elle demande une habitude : traiter la disponibilité comme une variable du plan média. Les agences qui gèrent plusieurs comptes clients sur la même instance découvriront, ces matins-là, un mode de panne corrélé. Tous les reportings baissent ensemble. Ce n’est pas une coïncidence créative. C’est un fournisseur commun. Le noter dans le compte rendu client protège la relation autant que la donnée.
Image de marque et tentation du commentaire à chaud
Chaque incident visible sur un réseau social produit un second incident : le fil de commentaires. Les marques technologiques sont tentées d’y placer une preuve de robustesse. Les marques grand public sont tentées d’y placer un trait d’humour. Les deux peuvent fonctionner si le fait est juste et le ton proportionné. Les deux se retournent si l’on se trompe d’instance, si l’on annonce la fin de l’attaque alors que l’opérateur dit le contraire, ou si l’on laisse entendre une compromission de comptes.
Dans le dossier relayé par la presse, le message de l’opérateur était mesuré. Enquête le matin. Contre-mesure et accessibilité en milieu de matinée. Instabilité possible tant que l’attaque continue. Seule l’instance principale visée à ce stade. Des millions de requêtes cohérentes avec un DDoS. C’est un modèle de communication d’incident : chronologie, périmètre, limite de ce que l’on sait. Une marque qui relaie gagne à conserver ces bornes, plutôt qu’à les arrondir en « Mastodon est tombé » ou « le Fediverse a résisté sans une égratignure ». Les deux formules sont trop larges.
Il y a aussi un enjeu de mémoire. Les captures d’écran d’erreur circulent plus longtemps que le correctif. Dans six mois, une recherche sur le nom du service pourra encore afficher l’écran rouge. D’où l’intérêt, pour l’opérateur comme pour les grands comptes présents sur l’instance, de garder une trace claire du rétablissement. Non pas pour effacer l’incident, mais pour que la trace dominante ne soit pas uniquement la panne. Les pages de statut publiques servent à cela. Les articles de suivi aussi, lorsqu’ils mettent à jour l’heure de retour à la normale.
Ce que cet épisode ne prouve pas
Il est tentant d’en faire une morale unique. Plusieurs lectures excessives méritent d’être écartées, précisément parce que le sujet intéresse des décideurs pressés.
Première lecture excessive : la décentralisation aurait échoué parce que le serveur le plus connu a été touché. C’est l’inverse du constat de Piper. Le serveur connu a été touché, et le réseau autour a continué. L’échec aurait été une coupure générale de tous les serveurs compatibles, ce qui n’est pas le tableau décrit.
Deuxième lecture excessive : la décentralisation rendrait les attaques sans objet. Un DDoS contre un nœud populaire reste pénible pour les personnes qui y ont leur compte, pour les liens qui y pointent, et pour l’équipe qui doit filtrer. Le confinement n’est pas l’absence de victime. Il est la limitation du nombre de victimes.
Troisième lecture excessive : il faudrait quitter ces réseaux au profit des seules plateformes centralisées, au motif qu’elles absorbent mieux les attaques. Les grandes plateformes subissent aussi des DDoS, des pannes logicielles et des erreurs de configuration. Leur avantage tient souvent au budget de capacité, pas à une immunité. Leur inconvénient tient à la concentration : quand elles s’arrêtent, il n’y a pas d’autre instance du même service. Comparer un budget d’infrastructure et une propriété d’architecture, c’est comparer deux questions différentes.
Quatrième lecture excessive : l’incident prouverait une offensive coordonnée contre toutes les alternatives, simplement parce que Bluesky a connu un épisode proche dans le calendrier. Rien, dans les éléments publics résumés ici, n’établit un lien entre les deux attaques. La coïncidence temporelle justifie la vigilance et le parallèle pédagogique. Elle ne justifie pas une attribution. Les marques qui republient des théories d’origine sans source se mettent un risque réputationnel inutile sur le dos.
Un cadre simple pour décider où poser son compte
Après un incident de cette nature, la question pratique revient : faut-il déplacer son compte ? Il n’y a pas de réponse unique. Il y a des critères que l’on peut écrire avant la prochaine alerte.
- Visibilité : avez-vous besoin du serveur que les articles citent par défaut, ou d’une communauté plus étroite ?
- Contrôle : pouvez-vous accepter les règles et les délais d’un opérateur tiers ?
- Secours : existe-t-il un domaine à vous qui reprend le message si le profil se tait ?
- Support : vos clients savent-ils vous écrire ailleurs si le fil social ne répond plus ?
- Mesure : votre reporting sait-il isoler un jour d’infrastructure d’un jour de contenu ?
- Partenaires : vos outils de publication distinguent-ils une panne distante d’une erreur de votre côté ?
Si la plupart des réponses penchent vers la dépendance, le déplacement d’une partie de la présence vers une autre instance, ou vers une page propre, est un projet raisonnable. Il n’a pas besoin d’être spectaculaire. Un second profil, annoncé calmement, avec les mêmes informations de contact, suffit souvent. Les utilisateurs avancés du Fediverse savent suivre un compte d’une instance à l’autre. Les autres suivront le lien que vous leur donnerez sur votre site.
Les médias qui ont ouvert un compte sur l’instance officielle pour « être là où l’on parle de nous » peuvent compléter, plutôt que remplacer. L’instance officielle reste un lieu de rencontre. Une instance de presse, ou simplement un site qui tient l’archive, tient le rôle de référence. Le DDoS du lundi montre la valeur de cette redondance éditoriale. Il ne condamne pas la présence sur le serveur touché. Il condamne la présence exclusive et non documentée.
Impact sur la confiance, au-delà du taux d’engagement
La confiance dans un réseau social se joue moins sur une matinée d’erreur que sur la répétition des explications. Un service qui dit tôt ce qu’il sait, qui corrige le périmètre, qui ne promet pas la fin de l’attaque avant l’heure, conserve un capital. Un service qui disparaît sans status page le consume. Mastodon, dans le récit disponible, a publié un point d’enquête puis un point de contre-mesure. C’est le minimum attendu. C’est aussi ce que beaucoup d’outils SaaS ne font pas encore lorsque leur propre API clignote.
Pour les utilisateurs, la confiance se joue aussi sur l’absence de surprise quant à la nature de l’incident. Répétons-le, parce que les rumeurs vont plus vite que les pages de statut : un DDoS vise la disponibilité. Il ne constitue pas, à lui seul, une preuve que des messages privés ont été lus ou que des identifiants ont fuité. Si un autre signal apparaissait, il faudrait le traiter à part. En l’état des informations publiques liées à cette matinée, le bon cadre reste celui de l’interruption de service.
Les annonceurs et les directions juridiques lisent parfois ces épisodes avec une grille plus froide. Un canal instable est un canal dont on ne peut pas garantir la diffusion d’un message réglementaire à l’heure dite. Cela ne concerne pas que la finance. Une rappel produit, une modification de conditions, une alerte météo d’entreprise, un avis de fermeture : autant de messages qui ne peuvent pas dépendre d’un fil tiers unique. Le Fediverse peut les relayer. Il ne doit pas les porter seul. Cette règle valait avant avril 2026. L’incident la rend simplement plus facile à défendre en comité.
Le rôle des prestataires de sécurité et la limite du chiffre spectaculaire
Le pic de 29,7 térabits par seconde cité par Cloudflare donne une échelle mondiale. Il ne décrit pas l’attaque contre mastodon.social. Mélanger les deux dans une même phrase choc produit un contresens. Une équipe de direction pourrait croire que son instance préférée a encaissé un record planétaire. Rien ne le dit. Le bon usage du chiffre est ailleurs : montrer que l’industrie de la mitigation travaille désormais sur des volumes extrêmes, et que la capacité à tenir quelques heures face à des millions de requêtes n’est déjà plus un exercice trivial pour une organisation de taille modeste.
Cette nuance intéresse les acheteurs d’hébergement et de protection. Demander « êtes-vous prêts pour un record mondial » est une mauvaise question. Demander « que se passe-t-il pendant les deux premières heures, qui décide du filtrage, comment prévenez-vous les clients, que deviennent les files de fédération » est une bonne question. Elle s’applique à un hébergeur d’instance, à un outil de planification, à une régie, à un site de contenu. Le DDoS n’est qu’un des scénarios. La qualité de la page de statut en est le révélateur commun.
Les prestataires qui vivent de la peur gagnent peu à exagérer cet épisode. Ceux qui vivent de la clarté peuvent s’en servir comme étude de cas : périmètre limité, rétablissement en milieu de matinée, avantage du maillage, persistance possible de l’instabilité. C’est un récit plus vendable, sur la durée, qu’une alerte sans contour. Les lecteurs business reconnaissent vite la différence entre un débrief et une accroche.
Fédération, modération et jours d’après
Une fois l’accès revenu, le travail n’est pas fini. Les messages partis pendant la fenêtre trouble peuvent avoir été délivrés en double, en retard, ou pas du tout. Les réponses écrites sur d’autres serveurs attendent peut-être encore d’être rapprochées. Les équipes de modération retrouvent une file plus longue. Les administrateurs surveillent si l’attaque reprend sous une autre forme. Pour une marque, la tentation est de republier en rafale tout ce qui n’est pas passé. Mieux vaut prioriser un message de reprise, puis réinjecter le calendrier, plutôt que de noyer les abonnés qui, eux, n’ont peut-être rien manqué s’ils étaient ailleurs.
Ce décalage d’expérience entre abonnés est le cœur pédagogique de l’affaire. Deux personnes peuvent suivre la même organisation et ne pas avoir vécu la même matinée, selon l’endroit où leur compte est ouvert. C’est déroutant si l’on pense encore en termes de « la plateforme ». C’est cohérent si l’on pense en termes de réseau de serveurs. Les formations internes au social media ont intérêt à inclure ce cas, avec un schéma simple : un nœud rouge, des nœuds verts, des flèches qui patientent. Pas besoin d’un cours de protocoles. Besoin d’une image mentale juste, pour que personne n’écrive « tout le monde a été coupé ».
Les jours d’après sont aussi ceux des décisions calmes. Faut-il financer l’instance que l’on utilise ? Faut-il ouvrir la nôtre ? Faut-il former le support au basculement ? Faut-il demander à l’agence un plan d’annotation des analytics ? Aucune de ces décisions n’exige de connaître l’auteur de l’attaque. Elles exigent d’accepter que la disponibilité d’un tiers fait partie de la qualité de service perçue de votre marque.
Ce que les directions communication peuvent écrire dans leur plan annuel
Un plan de présence digitale qui ignore les pannes tierces est incomplet. Voici, en prose, ce qu’une page interne peut contenir sans tomber dans le règlement illisible. Nous publions sur plusieurs canaux. Au moins un canal est sous notre nom de domaine. Les profils sur des instances tierces sont des relais, pas des archives. En cas d’indisponibilité signalée par l’opérateur, nous ne réécrivons pas la cause, nous renvoyons vers le point officiel, nous activons le canal propre pour les messages prioritaires. Nous n’interprétons pas un creux statistique ce jour-là comme un rejet de contenu. Nous revoyons une fois par an la liste des dépendances : instance, outil de planification, hébergeur d’images, raccourcisseur de liens.
Ce paragraphe tient en une demi-page. Il aurait suffi, le lundi de l’incident, à éviter la plupart des maladresses. Il est assez général pour survivre au prochain réseau, au prochain protocole, au prochain nom. Les organisations qui aiment les cadres plus formels peuvent le rattacher à leur plan de continuité d’activité. Les plus petites peuvent le coller dans le document d’onboarding du prochain community manager. L’important est qu’il existe avant le bandeau d’erreur, pas après.
On peut y ajouter une règle de ton. Nous ne moquons pas la panne d’un commun numérique dont nous sommes les invités. Nous ne revendiquons pas une immunité que notre propre site n’a pas. Nous ne mélangeons pas disponibilité et confidentialité. Trois interdits, plus utiles que dix consignes de style. Ils protègent autant la marque que la qualité du débat public autour de ces outils.
Lecture business de la chronologie, heure par heure
Reprenons la journée avec l’œil d’un responsable des opérations marketing, sans ajouter de faits à ceux qui ont été rendus publics. En début de matinée, heure de l’Est, le service est dégradé au point d’être inutilisable par moments. Autour de 7 heures, un statut indique une enquête sur l’attaque. C’est le moment où une équipe européenne de l’après-midi, ou une équipe américaine du matin, peut encore décaler une publication prévue. À 9 h 05, l’accès est annoncé, avec réserve sur la stabilité. C’est le moment où l’on peut tester un envoi, pas encore celui où l’on rattrape toute la file. En fin d’après-midi, une mise à jour de l’article de presse intègre le commentaire de l’organisation. Pour un veilleur, cette seconde vague d’informations est souvent plus utile que la première alerte : elle confirme le périmètre, le volume qualitatif, et l’argument sur les autres serveurs.
Cette chronologie enseigne aussi la patience éditoriale. Commenter à 7 h 10, c’est commenter une enquête. Commenter à 9 h 10, c’est commenter un rétablissement fragile. Commenter après le retour de l’opérateur, c’est commenter un périmètre. Les marques qui ont attendu le troisième temps ont moins de chances d’avoir à corriger un post. Dans un environnement où la correction se voit autant que l’erreur, l’attente est une compétence.
Le parallèle avec Bluesky renforce cette discipline. Là-bas, la stabilité revenue un soir n’équivalait pas, dans le point suivant, à la fin de l’attaque. Annoncer « c’est terminé » parce que les pages s’ouvrent est une confusion fréquente entre symptôme et cause. Les pages peuvent s’ouvrir grâce à une parade, pendant que le flux hostile continue. C’est exactement le type de nuance que Mastodon a laissée ouverte en parlant d’instabilité possible. La reprendre dans un relais de marque, c’est faire preuve de précision, pas de pessimisme.
Pourquoi le sujet concerne aussi l’e-commerce et l’acquisition
Un profil social n’est pas qu’un lieu de conversation. Il est souvent un maillon d’acquisition. Lien en bio, code promo du jour, relais d’un drop, service après-vente d’une commande. Si ce maillon se ferme deux heures un lundi, le manque à gagner direct est parfois faible. Le coût indirect l’est moins : clients qui écrivent ailleurs en colère, influenceurs qui ne peuvent pas poser leur lien, équipes paid qui constatent un taux de rebond bizarre sur une landing dont la preuve sociale devait venir du fil. Aucun de ces effets n’a été chiffré pour l’incident Mastodon, et il serait abusif d’inventer un montant. Le mécanisme, lui, est assez général pour figurer dans un plan d’acquisition.
La parade n’est pas d’abandonner les réseaux fédérés. Elle est de ne pas faire porter au bio social une information qui doit vivre sur une page stable : conditions d’une offre, délai de livraison, contact support, statut d’un incident produit. Le social annonce. Le site détaille. Quand le social tousse, le site reste. Cette répartition, banale en apparence, est encore rarement appliquée par les jeunes marques qui confondent vitesse de publication et architecture de l’information.
Les places de marché et les outils SaaS qui intègrent un partage vers Mastodon ont le même devoir de dégradation élégante. Si l’API distante ne répond pas, le bouton de partage doit échouer proprement, sans bloquer le paiement ni la création de compte. Un DDoS chez un partenaire social ne doit pas devenir une panne de caisse. Ce principe d’isolation est l’équivalent produit de la phrase de Piper sur les autres serveurs : ce qui n’a pas besoin de tomber ne tombe pas.
Une mémoire utile pour les prochaines alertes
Les incidents se ressemblent assez pour que l’on puisse garder une fiche. Nom du service touché. Nom exact de l’instance ou du fournisseur. Heure du premier statut. Nature annoncée, ici un DDoS, sans vol de données signalé. Périmètre, ici mastodon.social et non l’ensemble des serveurs. Heure d’accessibilité retrouvée. Réserve éventuelle sur la poursuite de l’attaque. Effet sur les comptes hébergés ailleurs. Source du point, afin de ne pas dépendre d’une capture isolée. Cette fiche tient sur une page. Elle évite, trois mois plus tard, de réécrire l’histoire en « Mastodon a été piraté » ou en « rien ne s’est passé ».
Elle sert aussi à comparer. L’épisode Bluesky, plus long, et l’épisode Mastodon, contenu en une matinée avec réserve, n’appellent pas le même niveau d’alarme opérationnelle. Les traiter comme un même bloc « les alternatives sont fragiles » appauvrit la décision. Une direction peut très bien juger acceptable une coupure rare de deux heures sur un relais, et inacceptable une instabilité de plusieurs jours sur un canal de support. Le critère est le rôle du canal, pas la mode du protocole.
Enfin, cette mémoire protège contre la fatigue. À force d’alertes, les équipes cessent de lire les status pages. Une fiche courte, intégrée au rituel du lundi, maintient l’habitude sans transformer chaque incident tiers en projet. Le but n’est pas de devenir un centre de sécurité. Le but est de ne pas laisser une infrastructure étrangère réécrire, sans annotation, la performance de votre communication.
Ce qu’il faut retenir pour la suite
L’attaque contre l’instance phare de Mastodon, telle qu’elle a été rapportée, est un incident de disponibilité ciblé, traité en quelques heures, avec une instabilité encore possible au moment du rétablissement annoncé. Elle n’a pas, d’après les éléments publics, le profil d’un vol de données. Elle a épargné, dans le récit de l’opérateur, les comptes ouverts sur d’autres serveurs du Fediverse. Elle survient peu après un épisode distinct chez Bluesky, où la stabilité du service est revenue avant la fin annoncée de l’attaque, et où les fournisseurs alternatifs du même protocole ont servi de refuge. Le record de volume cité par Cloudflare éclaire l’échelle mondiale des DDoS. Il ne décrit pas cet incident-ci.
Pour une audience de marketing, de startups et de communication digitale, la leçon tient en trois mouvements. Ne pas confondre le logiciel, l’instance et le réseau. Ne pas lire un creux statistique sans regarder la page de statut. Ne pas placer sur un relais tiers les messages qui doivent survivre à sa panne. La décentralisation, dans ce dossier, n’a pas été un slogan. Elle a été le fait que beaucoup d’utilisateurs n’ont rien vu. C’est déjà beaucoup. Ce n’est pas une raison pour cesser de prévoir le jour où, vous, vous verrez l’écran d’erreur.
Les organisations qui sortiront grandies de ce type de matinée ne seront pas celles qui auront le mieux théorisé le Fediverse. Ce seront celles qui auront un lien de secours, une phrase exacte, et un reporting honnête. Le reste, la mitigation, le filtrage, l’astreinte, appartient aux équipes qui opèrent les serveurs. Leur travail, ce lundi-là, a rendu le site de nouveau accessible avant la fin de la matinée américaine. Le nôtre, côté marques, commence quand on décide ce que l’on publie pendant que ce travail se fait, et ce que l’on archive pour le jour où il devra se refaire.
On peut refermer sur l’image la plus juste de l’épisode. Un grand serveur sous un flux de requêtes inutiles. Autour, des serveurs plus petits qui continuent d’échanger. Des utilisateurs qui, selon l’adresse de leur compte, vivent une panne ou une journée ordinaire. Des équipes de marque qui, si elles n’ont qu’une adresse, découvrent qu’elles avaient confondu un hébergeur avec un réseau. Cette image n’oppose pas les modèles. Elle rappelle une règle de métier : la continuité d’une conversation ne se délègue jamais entièrement. Même lorsque le protocole, comme ici, a fait exactement ce qu’on attendait de lui.