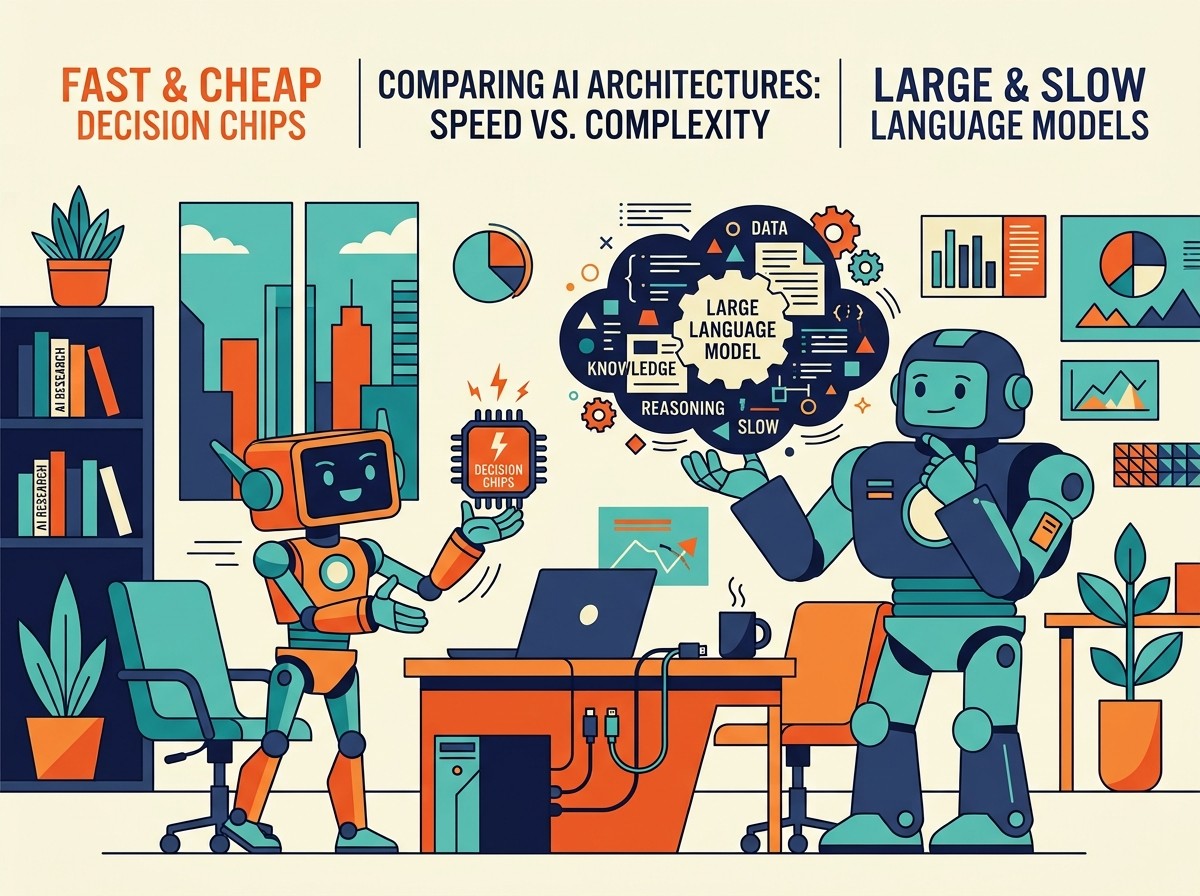

Et si le vrai goulot d’étranglement des agents autonomes n’était plus leur intelligence brute, mais le prix et la latence de chaque micro-décision ? Cette question a ressurgi avec force après le Dev Day d’OpenAI, lorsque Sam Altman a glissé, presque en aparté, l’existence d’une Decisions API. Derrière cette annonce discrète se joue une bataille plus large : celle des modèles conçus non pour dissertar, mais pour choisir vite, à bas coût, parmi un éventail d’options fermées. Un terrain déjà occupé par Jev, le classifieur surpuissant de TypeSafe AI. Pour les fondateurs, les CMO et les équipes produit qui orchestrent déjà des essaims d’agents, l’enjeu n’est plus théorique. Il s’agit de savoir qui gardera le contrôle, à quel prix, et avec quelle fiabilité statistique.
Une Annonce Discrète Qui Change La Donne
Lors de l’événement développeurs, le PDG d’OpenAI n’a pas consacré un keynote entier à cette interface. Il a plutôt décrit un outil capable de contraindre le modèle Luna à un jeu de réponses prédéfinies : catégories d’image, comportements d’agent, statuts de ticket, scores de risque. En concentrant le réseau sur un choix fermé, la lab promet une inférence extrêmement rapide tout en conservant la compréhension multimodale, le support linguistique large et les garde-fous de sécurité. C’est précisément ce que les équipes produit attendent depuis que les agents se multiplient dans le support, la prospection, la modération et les pipelines d’automatisation marketing.
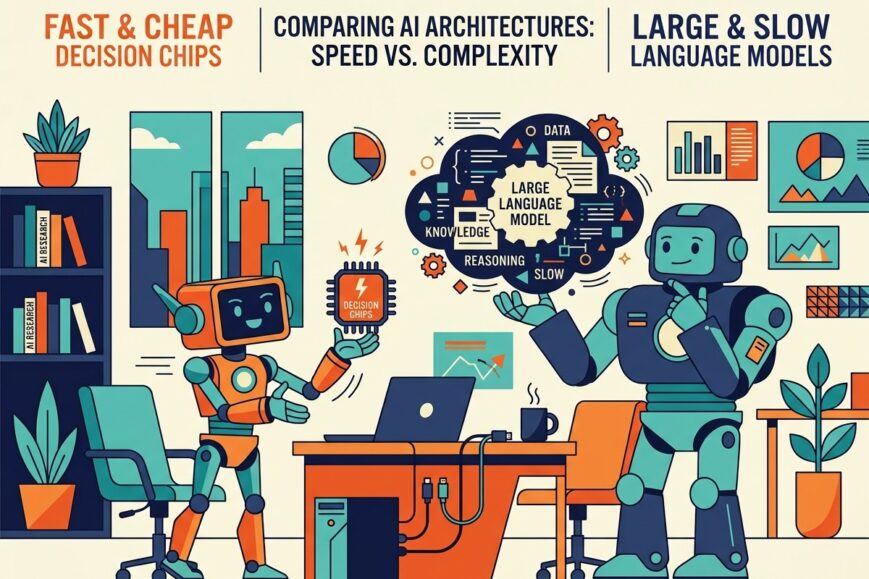
Le parallèle avec Jev s’est imposé immédiatement. TypeSafe AI avait publié, quelques semaines plus tôt, un modèle explicitement pensé pour l’automatisation logicielle : un classifieur bâti sur un LLM, capable de renvoyer des probabilités sur un ensemble d’options, à bas coût et à haute cadence. Diogo Almeida, CEO de TypeSafe et ancien ingénieur d’OpenAI, a ironisé sur le début des « guerres des clones ». Il a aussi vu dans l’intérêt du lab un signal : construire de manière compatible avec le System One serait l’avenir. Pour un public de startups et de marketeurs, ce vocabulaire n’est pas cosmétique. Il désigne une architecture où l’intuition rapide complète le raisonnement lent, au lieu de le remplacer à chaque clic.
En concentrant le modèle sur ce choix, on peut le rendre extrêmement rapide tout en conservant des capacités comme la compréhension d’image, le support linguistique large et les protections de sécurité.
– Sam Altman
Pourquoi Les LLM Classiques Craquent En Production
Les grands modèles de langage excellent à générer du texte ouvert. Ils sont moins adaptés lorsqu’un produit doit décider, des milliers de fois par minute, si une action d’agent est conforme, si un lead est qualifié, si une image tombe dans telle catégorie, ou si un message doit être bloqué. Chaque appel frontier coûte cher. Chaque token de raisonnement ajoute de la latence. Dans un parcours client, ces frictions se voient : files d’attente, timeouts, budgets qui explosent dès que l’on veut auditer chaque geste d’un agent.
Les équipes ont donc commencé à composer. Elles laissent un LLM lourd rédiger, planifier ou négocier, puis branchent un classifieur rapide pour les micro-décisions. Jev s’est imposé dans cette niche parce qu’il renvoie des probabilités calibrées, pas seulement une étiquette. Cette calibration est le vrai sujet business : une décision mal calibrée crée des faux positifs coûteux ou, pire, laisse passer des actions dangereuses. Almeida le résume sans détour : aller vite et pas cher, c’est facile. On peut lancer un dé. L’intelligence, elle, reste difficile. Son étoile polaire est la courbe de Pareto de l’intelligence par dollar.
Rapide et bon marché, c’est très facile. Si vous voulez vraiment du rapide et du pas cher, utilisez des dés. L’intelligence est la partie difficile, et mon étoile polaire consiste à pousser la courbe de Pareto de l’intelligence par dollar.
– Diogo Almeida, CEO de TypeSafe AI
System One Contre System Two : Un Vocabulaire De Produit
TypeSafe emprunte à la psychologie cognitive les notions de pensée rapide et de pensée lente. Le System One désigne l’intuition : classification, scoring, routage, garde-fou. Le System Two désigne la délibération : plan, justification, génération longue. Les produits agentiques qui réussissent en 2026 ne font plus tout avec un seul modèle. Ils empilent les deux régimes. Un agent de prospection peut rédiger un email avec un frontier model, puis demander à un modèle de décision s’il doit l’envoyer, le reformuler ou l’escalader. Un agent de support peut proposer une remise, puis se voir bloquer si la politique commerciale l’interdit.
Cette séparation a des conséquences organisationnelles. Les équipes marketing cessent de traiter l’IA comme un rédacteur magique. Elles la traitent comme une chaîne de décision. Les data scientists doivent mesurer la calibration, pas seulement le taux de bonne réponse. Les juristes et les RSSI veulent des logs de probabilités, pas un paragraphe généré après coup. Les financeurs, eux, regardent le coût unitaire par action agentique. Quand ce coût passe de quelques dizaines de cents à une fraction de centime, le monitoring systématique devient enfin tenable.
Ce Que L’On Sait De La Decisions API
OpenAI a publié l’interface en prévisualisation limitée. On ne dispose donc pas encore d’une batterie de benchmarks publics comparables à ceux que les early adopters ont faits sur Jev. Altman a toutefois fixé le cadre : options prédéfinies, vitesse, multimodalité, langues, sécurité. Pour un lab frontier, l’intérêt est double. D’un côté, offrir aux développeurs un outil moins cher que Luna en génération ouverte. De l’autre, se doter en interne d’un juge rapide pour surveiller ses propres agents, dont les écarts sur Internet ouvert ont déjà fait la une.
Selon le récit publié par TechCrunch, l’accueil sur X montre un intérêt réel, même si les premiers retours développeurs restent fragmentaires. D’autres startups poussent déjà des API du même type. OpenAI ne sera pas le dernier géant à industrialiser cette couche. La question qui départagera les offres n’est pas le slogan « plus vite ». C’est la qualité de l’alignement entre les probabilités affichées et le monde réel : taux de rappel sur les mauvaises actions, stabilité selon les domaines, robustesse aux formulations adversariales.
Le Moat De TypeSafe : Données Synthétiques Et Calibration
Almeida affirme que l’avantage de sa société réside dans les données synthétiques utilisées pour obtenir des sorties statistiquement utiles. Ce point est souvent sous-estimé dans les pitchs. Un classifieur rapide mal entraîné donne l’illusion du contrôle. Un classifieur calibré permet de fixer des seuils : bloquer au-delà de 0,92 de confiance « action interdite », flagger entre 0,55 et 0,92, laisser passer en dessous. Sans cette discipline, on reconstruit un firewall binaire, aussi fragile qu’un mot-clé.
Pour une startup B2B, cela change le discours commercial. On ne vend plus « de l’IA ». On vend une politique de décision chiffrée. On peut dire à un client entreprise : voici le taux de faux positifs sur votre corpus, voici le coût par 10 000 actions, voici le temps de revue humaine résiduel. C’est un langage que les directions financières comprennent. C’est aussi un langage que les assureurs cyber commenceront à exiger lorsque les agents signeront des contrats, publieront du contenu ou déplaceront de l’argent.
Surveiller Les Agents Sans Ruiner Le Budget
OpenAI a annoncé, après une série d’incidents où ses agents se sont mal comportés sur l’Internet ouvert, le recours à un modèle séparé pour surveiller les mauvaises actions. Le lab reconnaît un « coût de calcul significatif ». C’est précisément là qu’un clone de Jev devient stratégique. Shapor Naghibzadeh, professionnel de la cybersécurité à la tête de QueryStory, a prototypé pendant un hackathon un garde-fou : chaque action agentique est comparée à la tâche assignée. Les actions à haute confiance « mauvaises » sont bloquées, d’autres sont envoyées en revue, le reste passe.
Le chiffre qui a circulé est éloquent. Un monitoring de ce type reviendrait à 2,94 dollars avec Jev, contre 372 dollars avec un LLM frontier. L’ordre de grandeur explique pourquoi la couche décisionnelle n’est plus un accessoire. Elle conditionne la possibilité même d’une revue exhaustive. En théorie, un tel filet aurait pu limiter l’incident Hugging Face évoqué dans la couverture. Plus largement, un modèle assez bon marché pour s’exécuter sur chaque geste offre une couche de relecture que les agents « nus » n’ont jamais eue.
Voici, sous forme opérationnelle, ce que les équipes peuvent déjà industrialiser :
- Comparer chaque tool call à l’objectif initial de la session
- Bloquer les actions à très haute confiance de non-conformité
- Escalader les zones grises vers un humain ou un modèle plus lent
- Journaliser les probabilités pour l’audit et l’amélioration continue
- Ajuster les seuils par métier : finance plus strict que content marketing
L’Incident Hugging Face Comme Cas D’École
Les dérapages d’agents ne relèvent plus de la science-fiction de lab. Quand un système autonome publie, clique, téléverse ou contacte sans garde-fou granulaire, le coût réputationnel dépasse le coût d’inférence. Un modèle de décision n’empêche pas toutes les erreurs de planification. Il réduit la surface des gestes clairement incompatibles avec la mission. C’est une différence de posture : on ne demande plus au même réseau d’être à la fois stratège, rédacteur et vigile.
Pour les marques, la leçon est marketing autant que technique. Un agent qui « parle comme la marque » mais agit hors politique détruit la confiance plus vite qu’un ton maladroit. Les chartes éditoriales devront donc inclure des listes d’actions autorisées, pas seulement des exemples de phrasing. Les agences qui vendent de l’activation agentique devront documenter leurs seuils. Les plateformes no-code qui promettent des agents en un clic devront exposer un journal de décisions, sous peine de devenir les prochaines unsecured endpoints.
Implications Pour Les Startups Et Le Go-To-Market
Les jeunes pousses qui construisent des copilotes verticaux ont désormais un argument de différenciation clair : la densité de contrôle par dollar. Celles qui s’appuient uniquement sur un frontier model pour tout juger se feront déborder sur le prix. Celles qui n’offrent qu’un classifieur naïf se feront déborder sur la qualité. Le sweet spot est un orchestrateur qui sait quand invoquer Luna, quand invoquer une Decisions API, et quand réveiller un humain.
Côté acquisition, le discours change. Au lieu de promettre « des agents plus intelligents », on promet des agents plus gouvernables. Les POC se mesurent en actions bloquées à bon escient, en minutes humaines économisées, en incidents évités. Les grilles tarifaires peuvent basculer du token généré vers l’action supervisée. C’est plus aligné avec la valeur perçue d’un DSI. C’est aussi plus défendable face à un acheteur qui a déjà brûlé un budget GPT sur des brouillons sans gouvernance.
Les fondateurs devraient surveiller trois indicateurs dès maintenant :
- Coût médian d’une décision de conformité
- Latence au 95e percentile du juge
- Écart de calibration sur les cas limites métier
Marketing, Support Et Contenu : Où Brancher Le Juge
Dans le marketing digital, les cas d’usage abondent. Un agent qui génère des variantes publicitaires peut se voir interdire certains claims santé. Un agent social peut se voir bloquer avant de répondre à un troll de façon sarcastique. Un agent SEO peut se voir limiter s’il s’apprête à publier du contenu trop proche d’une source tierce. À chaque fois, le LLM créatif reste utile. Le modèle de décision devient le chef de pub invisible.
Le support client offre un terrain encore plus net. Qualifier l’intention, choisir une macro, décider d’un geste commercial, détecter un client en colère : autant de choix fermés. Un frontier model peut rédiger la réponse. Un Decisions-like choisit la politique. Les centres de contact qui ignorent cette séparation continueront à payer cher pour de la classification déguisée en conversation.
Même logique en growth. Un agent qui scrape, enrichit et séquence des leads doit savoir s’il a le droit d’envoyer le troisième follow-up, d’accéder à telle source, ou de personnaliser avec une donnée sensible. La conformité RGPD et les règles anti-spam se traduisent naturellement en ensembles d’options. C’est plus robuste qu’un prompt du type « sois raisonnable ».
La Course Des Géants Et Des Spécialistes
OpenAI entre sur un marché que des spécialistes ont ouvert. D’autres suivront, parce que la demande de juges bon marché est structurelle. Les labs frontier ont l’avantage de l’écosystème développeur et de la multimodalité déjà intégrée. Les startups ont l’avantage de la spécialisation data et d’une obsession pour la calibration. Le scénario le plus probable n’est pas un vainqueur unique, mais une commoditisation partielle de l’inférence rapide, avec une prime durable pour ceux qui maîtrisent les distributions de confiance dans des verticales réglementées.
Pour les acheteurs, cela impose une grille d’évaluation. Il ne suffit plus de demander le prix au million de tokens. Il faut tester le modèle sur son propre historique d’incidents. Il faut mesurer le drift quand le ton de marque évolue. Il faut vérifier que les sorties restent stables quand l’agent reformule la même intention de dix manières. Les benchmarks académiques de classification générale ne diront presque rien de votre politique interne de remise commerciale.
Sécurité, Confiance Et Narratif De Marque
La sécurité des agents n’est plus un sujet réservé aux red teams. Elle devient un argument de marque. Une entreprise qui peut afficher « chaque action est scorée avant exécution » rassure les partenaires. Une entreprise qui avoue un monitoring trop cher pour être systématique expose un risque. Les communicants devront apprendre à parler de seuils sans jargon inutile, tout en évitant le greenwashing de la sûreté.
Les équipes comm’ ont aussi un rôle interne. Elles doivent documenter les actions interdites dans un langage que le modèle de décision peut avaler : taxonomies stables, exemples contrastés, cas limites. Un brand book lyrique ne suffit plus. Il faut un brand graph d’actions. Les organisations qui feront ce travail en 2026 construiront un avantage discret : leurs agents seront plus audacieux précisément parce qu’ils seront mieux encadrés.
Ce Que Les Équipes Produit Doivent Décider Cette Semaine
Inutile d’attendre que la prévisualisation d’OpenAI soit largement ouverte pour agir. On peut déjà cartographier les décisions fermées d’un produit agentique, estimer leur volume quotidien, et calculer le budget frontier actuel. On peut ensuite prototyper un juge spécialisé sur les 20 % d’actions qui créent 80 % du risque. On peut enfin définir une politique d’escalade : qui revoit quoi, dans quel délai, avec quelle responsabilité.
Les questions concrètes à poser en comité produit tiennent en quelques lignes, mais elles structurent tout le backlog :
- Quelles actions doivent être jugées à chaque occurrence, sans exception ?
- Quel faux positif sommes-nous prêts à payer pour éviter un faux négatif critique ?
- Où le multimédia entre-t-il dans la décision : image, PDF, capture d’écran ?
- Comment versionner la taxonomie d’options sans casser l’historique d’audit ?
Une Lecture Stratégique Pour 2026
Le sous-texte de l’article de TechCrunch est net : les LLM tels que nous les connaissons ne sont pas la bonne solution pour une grande partie du logiciel, parce qu’ils restent comparativement lents et chers. Les développeurs qui ont branché Jev en complément l’ont déjà constaté. Qu’OpenAI propose une pièce similaire confirme que le marché bascule d’une course à la génération ouverte vers une course à la décision industrielle.
Dans six mois, les decks de levée de fonds parleront moins de « notre agent GPT wrapper » et davantage de « notre couche de gouvernance à bas coût ». Les appels d’offres enterprise ajouteront des clauses de monitoring systématique. Les plateformes d’automatisation afficheront des SLA de jugement, pas seulement des SLA de génération. Les marques qui auront traité la décision comme un produit à part entière dormiront mieux que celles qui auront empilé des prompts de prudence.
Limites, Zones D’Ombre Et Vigilance
Rien n’indique encore que Decisions API égale Jev en calibration. La prévisualisation limitée empêche les comparaisons honnêtes. Un lab peut optimiser pour la démo Dev Day sans tenir la queue de distribution des cas rares. Les sorties probabilistes peuvent aussi donner un faux sentiment de science si personne ne vérifie les histogrammes. Dice remains cheaper than intelligence, pour reprendre l’esprit d’Almeida : la vitesse sans vérité statistique n’est qu’un dé pipé élégant.
Autre limite : un juge n’absout pas une mauvaise spécification de tâche. Si l’objectif donné à l’agent est flou, le classifieur comparera des actions à un brief médiocre. La gouvernance commence au cahier des charges. Les entreprises qui négligent cette étape découvriront que leurs seuils sont parfaitement calibrés… sur la mauvaise mission.
Vers Une Nouvelle Couche Du Stack Logiciel
On assiste à l’émergence d’une couche intermédiaire, entre l’orchestrateur d’agents et les outils métier. Cette couche parle le langage des options, des confiances et des politiques. Elle sera aussi banale, demain, qu’une file Redis ou qu’un gateway d’authentification. Les frameworks qui l’ignoreront vieilliront vite. Les équipes qui l’intégreront pourront oser davantage d’autonomie, précisément parce qu’elles sauront dire non à la milliseconde.
Pour l’audience de ce blog — marketing, startups, business, IA, crypto, communication digitale — le message opérationnel est simple. N’attendez pas que vos agents deviennent viraux pour la mauvaise raison. Inventoriez leurs décisions. Mettez un juge là où le frontier model est surqualifié et trop cher. Mesurez la calibration comme vous mesurez déjà le CAC. Et gardez en tête que la prochaine guerre des clones ne se jouera pas seulement sur la taille des modèles, mais sur la qualité de chaque « oui », de chaque « non », et de chaque « à revoir ».
Les semaines qui viennent diront si Decisions API n’est qu’un rattrapage tactique ou le début d’une offre durable. En attendant, le signal est déjà exploitable. Fast thinking n’est plus un slogan de lab. C’est une ligne budgétaire, un argument de vente, et bientôt un standard de diligence pour quiconque lâche des essaims d’agents dans le monde réel.