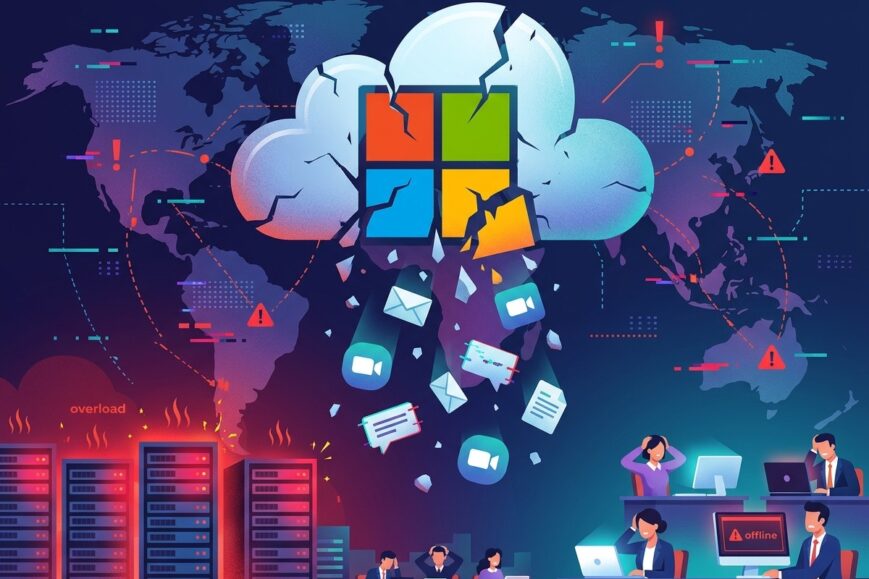
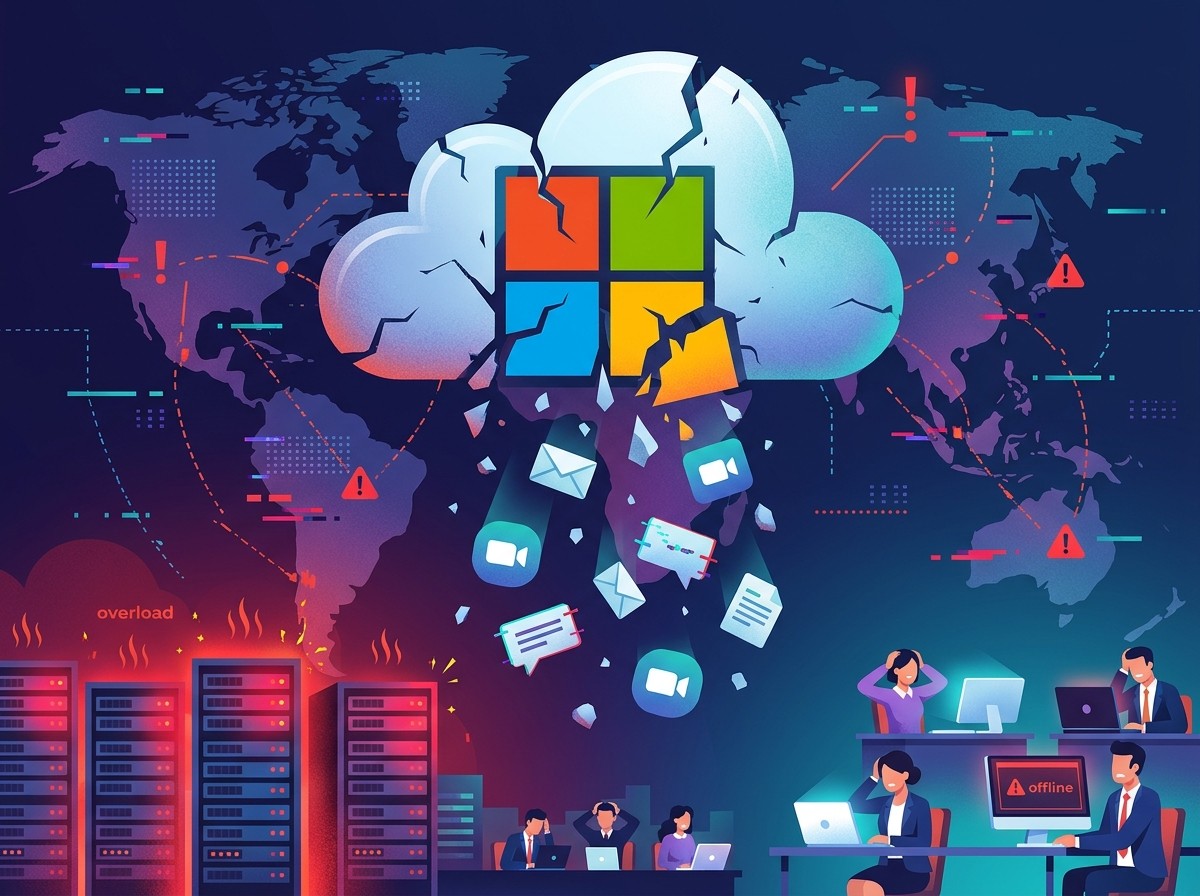

Imaginez un jeudi ordinaire où des millions de professionnels ouvrent leur boîte mail pour démarrer la journée… et rien ne se charge. Pas d’emails, pas de réunions Teams, pas d’accès aux documents partagés. Ce scénario n’est plus de la science-fiction : c’est exactement ce qui s’est produit lors de la récente panne Microsoft qui a rapidement basculé d’un simple incident Outlook vers une crise cloud mondiale. Pendant près de dix-huit heures, une large partie des services Microsoft 365 et Azure a été touchée, paralysant des entreprises, des administrations et même des médias. Pour les acteurs du marketing, des startups et de la transformation digitale, cet événement rappelle une vérité brutale : notre dépendance aux géants du cloud n’a jamais été aussi forte… ni aussi risquée.
Dans un monde où l’email reste le canal numéro un de communication professionnelle et où les outils collaboratifs structurent chaque journée de travail, une telle interruption a des conséquences immédiats et mesurables. Campagnes d’email marketing bloquées, réunions clients annulées, pipelines commerciaux interrompus, équipes marketing incapables d’accéder à leurs fichiers de création… la liste des dommages collatéraux est longue. Cet article décrypte en profondeur ce qui s’est passé, pourquoi la situation a dégénéré aussi vite, quels secteurs ont le plus souffert et surtout quelles leçons concrètes les entreprises peuvent en tirer pour renforcer leur résilience numérique.
Comment une panne email est devenue une crise cloud globale
Tout a commencé de manière relativement localisée. Les premiers signaux d’alerte concernaient principalement les services Outlook et Teams aux États-Unis et dans les Amériques. Très vite, le problème s’est propagé à l’échelle planétaire. Les ingénieurs Microsoft se sont retrouvés face à un phénomène en cascade : des serveurs devenaient soudainement indisponibles en grand nombre, entraînant des effets domino sur l’ensemble de l’écosystème cloud de l’entreprise.
Ce qui semblait au départ un simple dysfonctionnement de messagerie a rapidement impacté les fichiers OneDrive et SharePoint, les outils Copilot d’intelligence artificielle, les solutions de sécurité Defender, les consoles d’administration Intune et même l’accès à certains postes de travail Windows hébergés dans le cloud. En quelques heures, des pans entiers de la productivité numérique mondiale se sont retrouvés hors service.
Microsoft a indiqué qu’un « grand nombre de serveurs étaient devenus inopinément indisponibles ». Aucune activité malveillante n’a été détectée selon les déclarations officielles. L’entreprise a également écarté tout lien avec des agents d’intelligence artificielle ou une attaque cyber. Pourtant, l’absence de cause clairement identifiée dans les premières heures a amplifié le sentiment d’inquiétude chez les administrateurs systèmes et les dirigeants.
Nous observons des progrès encourageants dans la reprise, avec une disponibilité des services et des performances de livraison d’emails qui s’améliorent sur une portion croissante de l’infrastructure affectée.
– Charles Lamanna, vice-président exécutif Microsoft pour Copilot, agents et plateforme
Cette déclaration, publiée alors que la situation commençait à s’améliorer, illustre bien le ton prudent adopté par l’entreprise. Après environ dix-huit heures de perturbation majeure, le trafic vers les services Microsoft a recommencé à progresser, selon les observations d’analystes indépendants spécialisés dans le monitoring internet.
Les services touchés : bien plus qu’une simple messagerie
Pour comprendre l’ampleur réelle de la crise, il faut regarder la liste des services impactés. Outlook et Teams ont été les plus visibles, mais ils n’étaient que la partie émergée de l’iceberg. Les utilisateurs professionnels ont perdu temporairement l’accès à leurs documents collaboratifs, à leurs outils d’intelligence artificielle intégrés et même à certaines fonctionnalités de sécurité essentielles.
Voici un aperçu synthétique des impacts constatés :
- Messagerie Outlook et échanges professionnels interrompus pour des millions d’utilisateurs
- Réunions Teams et appels vidéo impossibles ou très dégradés
- Accès limité ou impossible aux fichiers cloud OneDrive et SharePoint
- Outils Copilot d’assistance IA hors service
- Solutions de sécurité Defender perturbées
- Consoles d’administration Intune inaccessibles pour de nombreux responsables IT
- Difficultés d’accès à certains postes Windows hébergés dans le cloud
Cette combinaison d’impacts a créé une situation particulièrement complexe pour les entreprises qui avaient misé lourdement sur l’écosystème Microsoft pour leur productivité quotidienne. Les équipes marketing n’ont plus pu lancer ou suivre leurs campagnes email. Les commerciaux ont perdu l’accès à leurs outils de suivi. Les équipes créatives n’ont plus pu collaborer sur leurs fichiers. Et les responsables IT se sont retrouvés sans vision claire sur l’état de leurs systèmes.
Pourquoi la reprise a pris autant de temps
L’un des points les plus frappants de cet incident reste la durée de la perturbation. Dix-huit heures peuvent sembler raisonnables pour un problème technique complexe, mais dans l’économie numérique actuelle, c’est une éternité. Chaque heure d’indisponibilité se traduit par des pertes de productivité, des opportunités manquées et une érosion de confiance.
Les équipes techniques Microsoft ont d’abord eu du mal à identifier la cause racine. Lorsque des milliers de serveurs deviennent simultanément indisponibles, le diagnostic devient extrêmement délicat. Les systèmes de monitoring eux-mêmes peuvent être affectés, et les procédures de recovery doivent être appliquées avec une extrême prudence pour éviter d’aggraver la situation.
Cette difficulté à rétablir rapidement le service soulève des questions légitimes sur la résilience des architectures cloud hyper-centralisées. Même les acteurs les plus avancés techniquement peuvent se retrouver confrontés à des situations où la complexité du système dépasse la capacité de diagnostic rapide des équipes humaines.
Impact concret sur les entreprises et les équipes marketing
Pour les professionnels du marketing digital, de la communication et des startups, cette panne a eu des conséquences très tangibles. L’email reste, malgré l’essor des réseaux sociaux et des messageries instantanées, le canal de conversion le plus rentable pour la majorité des entreprises. Lorsqu’il devient inaccessible, c’est tout un pan de l’acquisition et de la fidélisation client qui s’arrête net.
Les campagnes automatisées ont continué à générer des leads… qui n’ont pu être traités. Les newsletters planifiées n’ont pas été livrées. Les réponses aux prospects se sont accumulées sans pouvoir être envoyées. Dans certains cas, des équipes ont dû improviser des solutions de secours via des adresses personnelles ou des outils alternatifs, avec tous les risques de sécurité et de conformité que cela implique.
Les startups, souvent encore plus dépendantes d’outils SaaS uniques pour limiter leurs coûts, ont particulièrement souffert. Une jeune entreprise qui s’appuie exclusivement sur Microsoft 365 pour sa collaboration interne et sa communication client se retrouve dans une situation de quasi-paralysie lorsqu’une telle panne survient.
Le précédent de septembre et la question de la récurrence
Ce n’est pas la première fois que Microsoft connaît un incident majeur. Quelques semaines plus tôt, en septembre, une panne liée à un problème de configuration d’authentification centrale avait déjà perturbé l’accès aux services cloud pendant plusieurs jours. La répétition de ces événements à intervalle rapproché commence à interroger les entreprises sur la fiabilité réelle de leur fournisseur principal.
Deux incidents majeurs en quelques mois, même s’ils ont des causes différentes, finissent par créer un climat de méfiance. Les directions générales et les comités de direction commencent à demander des comptes aux DSI. Les contrats de niveau de service (SLA) sont scrutés à la loupe. Et la question du multicloud ou de solutions de secours revient sur la table avec une urgence nouvelle.
Ce que Microsoft a (et n’a pas) communiqué
La communication de crise de Microsoft a été relativement classique : mises à jour régulières sur le statut des services, confirmation de l’absence d’activité malveillante, puis messages de reprise progressive. L’entreprise a insisté sur le fait que l’incident n’était lié ni à une cyberattaque ni à des agents d’intelligence artificielle.
En revanche, plusieurs questions restent sans réponse claire à ce stade. Quelle était exactement la cause technique profonde ? Pourquoi le problème s’est-il propagé aussi largement et aussi rapidement ? Quels mécanismes de détection et de confinement ont échoué ? Microsoft a indiqué que ses équipes analysaient l’incident pour éviter qu’il ne se reproduise, mais les détails techniques précis manquent encore.
Cette relative opacité est fréquente chez les grands fournisseurs cloud. Les enjeux de réputation et de concurrence sont tels que les entreprises préfèrent souvent rester prudentes dans leurs déclarations publiques. Pour les clients, cela signifie devoir prendre des décisions de résilience sans disposer de toutes les informations techniques souhaitables.
Les leçons à tirer pour les entreprises dépendantes du cloud
Cette crise offre une opportunité rare de réfléchir collectivement à notre modèle de dépendance technologique. Voici les principaux enseignements que les directions marketing, les startups et les entreprises de taille intermédiaire peuvent en retirer.
1. La redondance n’est plus un luxe
Disposer d’une solution de messagerie de secours, même basique, devient un impératif. Cela peut prendre la forme d’un compte secondaire chez un autre fournisseur, d’une solution de forwarding d’urgence ou d’un canal de communication alternatif clairement identifié et testé régulièrement.
2. Le multicloud n’est plus réservé aux grandes entreprises
Même les structures de taille moyenne peuvent aujourd’hui envisager une stratégie de diversification raisonnable. Conserver certains fichiers critiques hors du cloud principal, utiliser des outils collaboratifs complémentaires et prévoir des scénarios de bascule font partie des bonnes pratiques émergentes.
3. La communication de crise interne doit être anticipée
Lorsque les outils habituels sont hors service, comment l’entreprise continue-t-elle à communiquer en interne ? Avoir un plan B (groupe WhatsApp d’urgence, liste de diffusion SMS, canal Slack alternatif…) peut faire la différence entre une organisation qui garde le contrôle et une organisation qui s’éparpille.
4. Les SLA ne protègent pas de tout
Les engagements contractuels de disponibilité sont importants, mais ils ne compensent jamais totalement les pertes d’activité réelles. Une indemnisation financière, même significative, ne remplace pas les opportunités commerciales perdues ni la confiance clients érodée.
Impact spécifique sur l’intelligence artificielle et Copilot
L’indisponibilité des outils Copilot pendant la panne a particulièrement marqué les esprits. En quelques mois, de nombreuses entreprises ont commencé à intégrer ces assistants d’intelligence artificielle dans leurs processus quotidiens de rédaction, d’analyse et de création de contenu. Voir ces outils disparaître brutalement a rappelé que l’IA générative reste, pour l’instant, profondément dépendante de l’infrastructure cloud sous-jacente.
Pour les équipes marketing qui avaient commencé à industrialiser l’usage de Copilot pour la génération de contenus, la préparation de briefs ou l’analyse de données, la panne a créé un trou d’air notable. Cela pose la question de la robustesse des workflows basés sur l’IA et de la nécessité de conserver des compétences humaines capables de prendre le relais en cas d’indisponibilité des outils.
La dimension géopolitique et de souveraineté numérique
Au-delà des aspects purement techniques et business, cet incident relance le débat sur la souveraineté numérique. Lorsqu’une panne chez un acteur américain unique peut paralyser simultanément des entreprises européennes, asiatiques et américaines, la question de la concentration des risques devient politique.
De nombreux gouvernements et grandes organisations publiques observent ces événements avec attention. Les stratégies de cloud souverain, de multicloud réglementé ou de solutions hybrides gagnent en crédibilité à chaque nouvel incident majeur. Pour les startups et les scale-ups qui travaillent avec des clients publics ou des secteurs régulés, cette dimension devient un argument commercial de plus en plus important.
Comment les entreprises les plus matures se préparent déjà
Les organisations qui avaient déjà intégré la résilience cloud dans leur culture ont mieux traversé la tempête. Elles disposaient généralement de plusieurs éléments clés :
- Des procédures de continuité d’activité régulièrement testées
- Des canaux de communication alternatifs identifiés et connus des équipes
- Une politique de sauvegarde et de synchronisation hors du cloud principal pour les données critiques
- Des indicateurs de monitoring externes permettant de détecter rapidement les problèmes
- Une culture interne qui accepte l’idée qu’aucun fournisseur n’est infaillible
Ces entreprises n’ont pas évité totalement les impacts, mais elles ont limité les dégâts et ont pu maintenir un niveau minimal d’activité pendant toute la durée de la panne. C’est précisément cette capacité à « absorber le choc » qui fait aujourd’hui la différence entre les organisations résilientes et les autres.
Les questions que doivent se poser les directions marketing et digitales
Si vous dirigez une équipe marketing, une startup ou une business unit digitale, voici les questions concrètes à mettre sur la table dès maintenant :
Quels sont nos processus les plus critiques qui dépendent exclusivement de Microsoft 365 ou d’Azure ? Avons-nous un plan de communication de crise si Teams et Outlook sont indisponibles pendant une journée entière ? Nos campagnes d’acquisition et de nurturing peuvent-elles continuer à fonctionner en mode dégradé ? Dispose-t-on de listes de contacts d’urgence accessibles hors cloud ? Nos équipes savent-elles quoi faire et dans quel ordre en cas de nouvelle panne majeure ?
Ces questions peuvent sembler anxiogènes, mais elles sont en réalité libératrices. Y répondre permet de reprendre le contrôle et de transformer un risque subi en risque maîtrisé.
Vers une nouvelle culture de la résilience numérique
La panne Microsoft de novembre 2026 restera probablement comme l’un des incidents cloud les plus significatifs de l’année. Non pas tant par sa durée que par l’étendue des services touchés et par le moment où elle survient : une période où la dépendance aux outils collaboratifs et à l’intelligence artificielle n’a jamais été aussi forte.
Pour les entreprises, l’enjeu n’est plus seulement de choisir le meilleur fournisseur cloud. Il s’agit désormais de construire des organisations capables de continuer à fonctionner, même imparfaitement, lorsque ce fournisseur connaît un incident majeur. Cela implique des choix techniques, organisationnels et culturels.
Les startups et scale-ups ont ici une carte à jouer. Plus agiles que les grands groupes, elles peuvent mettre en place plus rapidement des stratégies de diversification et des plans de continuité adaptés à leur taille. Celles qui le feront gagneront un avantage compétitif réel en termes de fiabilité perçue auprès de leurs clients et partenaires.
Ce qu’il faut retenir pour l’avenir
La concentration des services numériques chez quelques acteurs majeurs crée des points de défaillance uniques à l’échelle mondiale. Même les entreprises les plus avancées techniquement ne sont pas à l’abri d’incidents complexes et longs à résoudre. La communication transparente et rapide reste un élément clé de la gestion de crise, mais elle ne remplace pas la préparation en amont.
Pour les professionnels du marketing, de la communication et du digital, l’épisode rappelle que la performance des campagnes et la qualité de l’expérience client dépendent aussi de la solidité de l’infrastructure sous-jacente. Investir dans la résilience n’est pas un coût : c’est une forme d’assurance qui protège la valeur créée au quotidien.
Alors que Microsoft continue d’analyser les causes profondes de cet incident et de renforcer ses mécanismes de détection et de recovery, les entreprises ont tout intérêt à profiter de cette fenêtre de lucidité collective pour réexaminer leurs propres architectures et leurs propres plans de continuité. La prochaine panne majeure n’est probablement qu’une question de temps. La seule question qui vaille est : serons-nous prêts ?
Dans un environnement économique déjà incertain, la capacité à maintenir l’activité malgré les aléas technologiques devient un véritable facteur de différenciation. Les organisations qui traiteront cet événement comme un simple fait divers risquent de se retrouver démunies lors du prochain incident. Celles qui en feront un catalyseur de transformation renforceront durablement leur position.
La crise cloud de novembre 2026 restera comme un cas d’école. Elle illustre parfaitement les forces et les fragilités de notre modèle économique numérique. À nous, désormais, d’en tirer toutes les conséquences opérationnelles et stratégiques.
Les équipes qui sortiront renforcées de cet épisode seront celles qui auront su transformer la contrainte en opportunité : opportunité de revoir leurs architectures, de former leurs collaborateurs à la gestion de crise, de diversifier intelligemment leurs outils et de bâtir une véritable culture de la résilience. Dans un monde où la disponibilité des services cloud n’est plus jamais garantie à 100 %, cette culture devient l’un des actifs les plus précieux d’une organisation.
En définitive, la panne Microsoft n’est pas seulement un incident technique. C’est un miroir tendu à l’ensemble de l’écosystème digital. Il révèle notre niveau de dépendance, nos angles morts organisationnels et notre capacité réelle à encaisser les chocs. Pour les acteurs du marketing, des startups et de la tech, le moment est venu de regarder ce miroir en face et d’agir en conséquence.