
Vous avez passé des semaines à peaufiner un livre blanc de soixante pages, à soigner chaque graphique et à vérifier trois fois les sources. Vous le mettez en ligne en PDF, vous attendez le trafic organique… et presque rien ne se passe. Pendant ce temps, des pages HTML plus légères grimpent dans les résultats. Ce scénario, des centaines d’équipes marketing B2B le vivent chaque année. Le 13 octobre 2026, Martin Splitt et John Mueller ont enfin levé le voile dans l’épisode 115 de Search Off the Record. Ils ont expliqué précisément comment Google traite les fichiers PDF, de l’exploration jusqu’aux réponses générées par l’intelligence artificielle. Voici tout ce qu’il faut retenir pour arrêter de gaspiller du budget crawl et transformer vos documents techniques en véritables leviers de visibilité.
Pourquoi les PDF restent un format stratégique en marketing B2B
Dans l’univers des startups SaaS, des industriels et des cabinets de conseil, le PDF conserve un statut presque sacré. Il incarne la crédibilité. Un rapport d’étude de marché, une fiche technique détaillée ou un livre blanc téléchargeable contre une adresse e-mail reste l’un des meilleurs outils de génération de leads. Les décideurs aiment pouvoir l’imprimer, le annoter ou le faire circuler en interne sans dépendre d’une connexion internet. Pourtant, ce format confortable pour l’humain n’est pas toujours optimal pour les robots de Google.
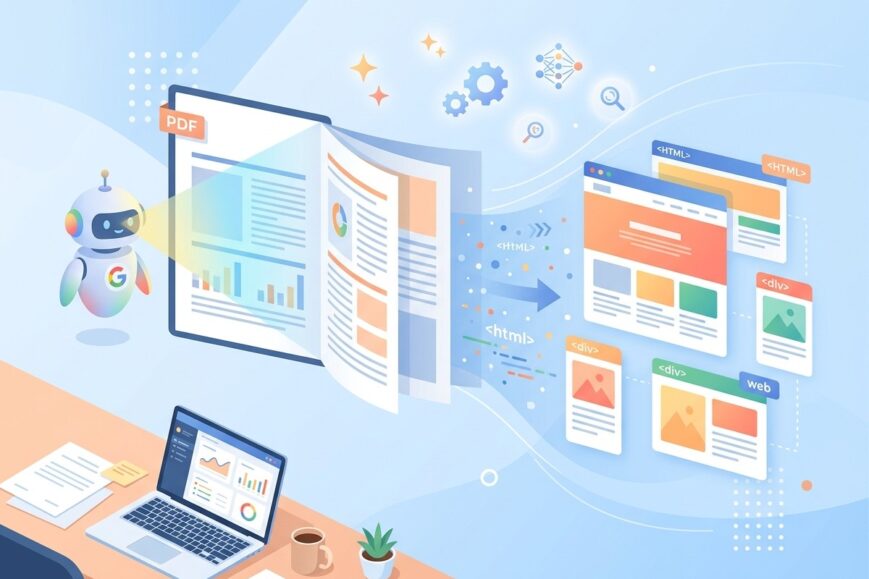
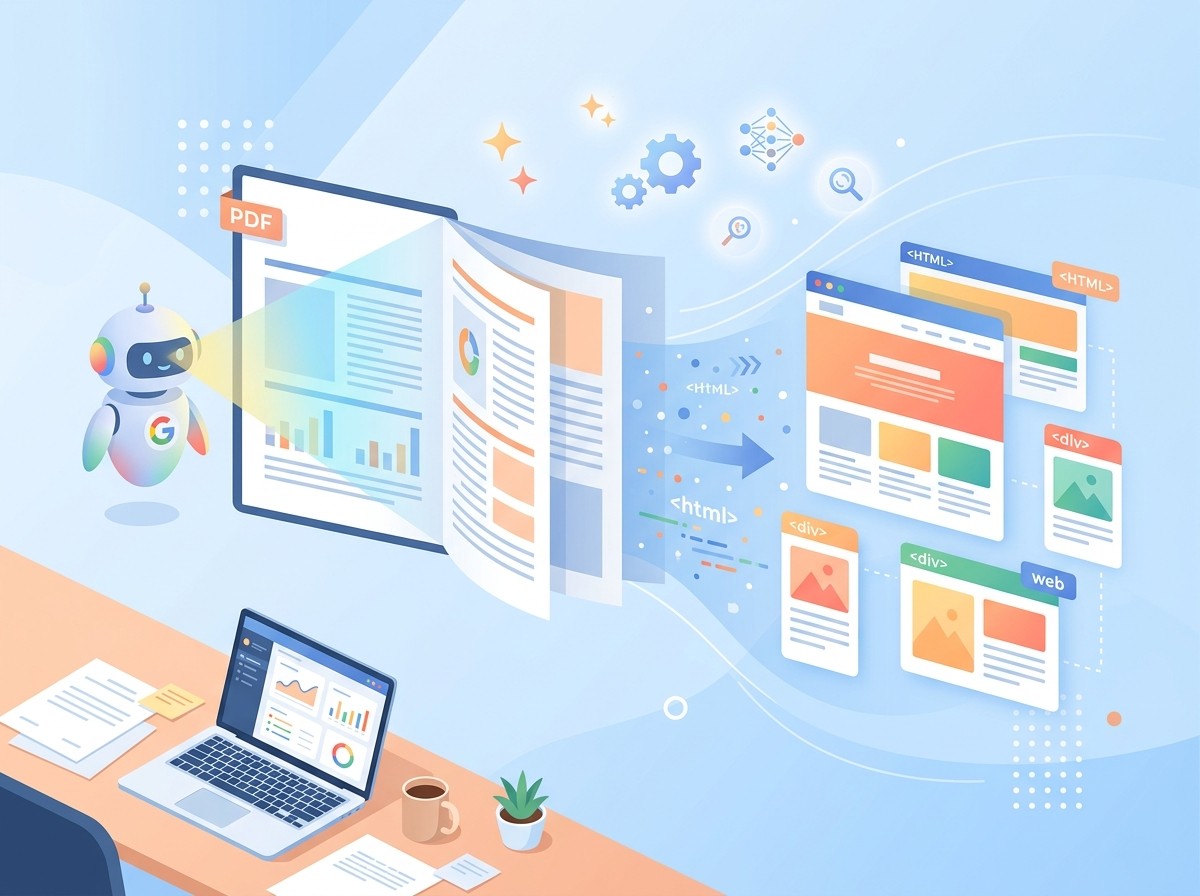
Le paradoxe est flagrant. D’un côté, les équipes content multiplient les PDF parce qu’ils convertissent bien. De l’autre, les spécialistes SEO constatent que ces mêmes fichiers apportent souvent peu de trafic organique durable. L’épisode de Search Off the Record apporte enfin des réponses claires et chiffrées. Google convertit le contenu textuel du PDF en HTML lors de l’indexation. Une fois cette transformation effectuée, le fichier est traité presque comme une page web classique. Il peut même apparaître dans les AI Overviews, ces synthèses générées par l’intelligence artificielle qui monopolisent de plus en plus la première position des résultats.
Cette information change la donne. Vos études de marché ou vos white papers ne sont plus condamnés à rester invisibles. Ils peuvent être cités par l’IA de Google, à condition que le texte soit réellement extractible. Un simple test de sélection et de copier-coller dans un éditeur de texte suffit pour vérifier si votre document est lisible par les robots. Si le texte ne se sélectionne pas, Google ne le lira pas non plus.
Comment Google transforme réellement un PDF en contenu indexable
Le processus d’indexation d’un PDF n’est pas magique. Googlebot télécharge le fichier, extrait le texte, le convertit en HTML, puis l’injecte dans le pipeline d’indexation habituel. À partir de là, le contenu peut se classer sur des requêtes concurrentielles et alimenter les fonctionnalités d’IA. Les liens textuels présents dans le document sont conservés et explorés. C’est une bonne nouvelle pour ceux qui ont pris le temps d’ajouter des hyperliens vers des pages stratégiques de leur site.
En revanche, les images intégrées dans un PDF posent problème. Contrairement à une page HTML où chaque image possède sa propre URL, les illustrations d’un PDF n’ont généralement pas d’adresse indépendante. Résultat : elles n’apparaissent presque jamais dans Google Images. Pour les marques qui misent beaucoup sur le visuel, c’est un manque à gagner important.
La limite de taille constitue un autre point crucial. Selon la documentation officielle de Googlebot mise à jour en février 2026, le robot explore les 64 premiers Mo d’un fichier PDF. Pour une page HTML, la limite tombe à seulement 2 Mo. Sur le papier, le PDF dispose donc d’une marge confortable. Dans la pratique, peu de livres blancs dépassent les 20 ou 30 Mo. La contrainte réelle se situe ailleurs : la fréquence de récrawl. Un PDF est revisité beaucoup moins souvent qu’une page HTML. Si vous publiez une version actualisée de votre étude annuelle sous la même URL, Google peut mettre des mois à s’en apercevoir.
Google convertit le texte indexable d’un PDF en HTML. Le reste du pipeline le traite ensuite comme une page classique.
– Synthèse des propos de Martin Splitt et John Mueller, Search Off the Record épisode 115
Tableau comparatif HTML versus PDF selon Google
Pour visualiser clairement les différences, voici un récapitulatif direct tiré des informations partagées par Google et confirmées par plusieurs sources spécialisées :
Taille explorée par Googlebot : 2 premiers Mo pour le HTML contre 64 premiers Mo pour le PDF.
Traitement des liens : tous les liens sont explorés en HTML ; seuls les liens textuels le sont de façon fiable dans un PDF.
Éligibilité des images : une image HTML possède une URL propre et peut apparaître dans Google Images ; une image PDF n’en a généralement pas et reste invisible dans ce service.
Fréquence de récrawl : nettement plus élevée pour les pages HTML que pour les fichiers PDF.
Ce tableau montre que le PDF bénéficie d’une tolérance de taille généreuse, mais qu’il perd sur presque tous les autres critères importants pour le référencement naturel. Google le dit sans détour : le HTML reste le format préféré pour publier un contenu destiné à être découvert et classé.
Les pièges techniques qui bloquent l’indexation des PDF
Plusieurs erreurs classiques empêchent un PDF d’être correctement indexé. Le premier piège concerne les documents scannés. Si vous avez numérisé un rapport papier sans passer par une reconnaissance optique de caractères de qualité, Google ne verra qu’une image. Le texte n’est pas extractible. Le test du copier-coller reste le plus simple et le plus fiable pour vérifier ce point.
Deuxième obstacle fréquent : la protection par mot de passe. Un PDF verrouillé bloque purement et simplement les robots. Même si le document est excellent, Googlebot ne pourra pas y accéder. Il faut donc toujours proposer une version non protégée destinée à l’indexation, quitte à réserver une version verrouillée pour les téléchargements après formulaire.
Troisième problème : la multiplication des copies identiques. Dans le monde B2B, il est courant qu’une fiche technique soit hébergée à la fois sur le site du fabricant, sur celui d’un distributeur et sur plusieurs plateformes partenaires. Ces fichiers en double compliquent la canonicalisation. Google a proposé trois solutions concrètes lors de l’épisode :
- Utiliser un en-tête HTTP rel= »canonical » pointant vers la version officielle
- Renseigner les métadonnées internes du PDF avec l’URL canonique
- Intégrer un lien textuel visible vers le site principal à l’intérieur même du document
Ces trois méthodes aident Google à comprendre quelle version doit être considérée comme la source principale. Sans elles, le moteur risque de diluer le signal entre plusieurs URL et de n’en classer aucune correctement.
Impact des PDF sur le budget de crawl de votre site
Le budget de crawl n’est pas infini. Chaque fois que Googlebot télécharge un gros PDF, il consomme une partie de ce budget. Sur un site qui publie régulièrement des documents de plusieurs dizaines de mégaoctets, la facture peut devenir significative. Les 64 Mo de limite constituent certes une marge confortable, mais le robot passe du temps à les analyser. Ce temps n’est plus disponible pour explorer de nouvelles pages HTML ou pour mettre à jour des contenus stratégiques.
La recommandation de Google est limpide : publiez une version HTML indexable de votre contenu principal et proposez le PDF uniquement en téléchargement. Cette approche offre le meilleur des deux mondes. La page HTML se charge rapidement, se récrawl souvent, s’affiche parfaitement sur mobile et peut contenir des éléments interactifs. Le PDF, quant à lui, reste disponible pour les utilisateurs qui souhaitent une version imprimable ou hors ligne, et sert de levier de génération de leads.
Pour les équipes qui gèrent déjà un catalogue important de documents, la première étape consiste à analyser la Search Console. Identifiez les PDF qui reçoivent réellement du trafic organique. Ceux-là méritent d’être doublés d’une page HTML. Les fichiers qui n’apportent aucun clic peuvent rester en PDF pur, ou être optimisés progressivement.
Les PDF et les fonctionnalités d’intelligence artificielle de Google
L’un des enseignements les plus intéressants de l’épisode 115 concerne les AI Overviews. Google a confirmé que les contenus issus de PDF peuvent être cités dans ces synthèses générées par l’IA, à condition que le texte soit lisible. Pour les spécialistes du GEO (Generative Engine Optimization), cette information est précieuse. Un livre blanc bien structuré, avec des titres clairs, des données chiffrées et des sources identifiables, a de fortes chances d’être repris par les modèles de langage de Google.
Cette possibilité ouvre de nouvelles perspectives. Au lieu de considérer le PDF uniquement comme un outil de conversion, on peut désormais le penser comme une source potentielle pour les réponses génératives. Les entreprises qui produisent des études originales, des benchmarks ou des analyses de marché se trouvent dans une position favorable. Leur expertise peut être mise en avant non seulement dans les résultats classiques, mais aussi dans les blocs d’IA qui captent une part croissante de l’attention des utilisateurs.
Pour maximiser ces chances, quelques bonnes pratiques s’imposent. Structurez le document avec des titres hiérarchisés. Incluez des tableaux de données plutôt que des images de tableaux. Citez vos sources de manière explicite. Évitez les polices trop décoratives qui peuvent perturber l’extraction de texte. Et surtout, testez systématiquement la sélection du contenu avant publication.
Stratégie recommandée pour les prochains livres blancs
Face à ces révélations, la stratégie la plus efficace consiste à adopter une approche hybride. Voici un plan d’action concret que vous pouvez appliquer dès maintenant :
- Rédigez d’abord le contenu en pensant page web : titres H2 et H3, paragraphes aérés, listes à puces, données chiffrées
- Publiez une version HTML complète et optimisée SEO sur votre site
- Créez ensuite le PDF à partir de cette version, en veillant à ce que le texte reste extractible
- Proposez le PDF en téléchargement derrière un formulaire pour collecter des leads qualifiés
- Ajoutez un lien visible vers la page HTML à l’intérieur du PDF
- Utilisez une nouvelle URL à chaque mise à jour majeure du document
Cette méthode permet de profiter de la puissance d’indexation du HTML tout en conservant le pouvoir de conversion du PDF. Elle répond également aux attentes de Google, qui privilégie clairement le format web pour la découverte de contenu.
Cas particulier des fiches techniques et documents industriels
Les fabricants et les éditeurs de logiciels rencontrent souvent un problème spécifique. Leurs fiches techniques circulent chez de nombreux distributeurs et partenaires. Chaque acteur héberge sa propre copie, parfois légèrement modifiée. Cette dispersion dilue le signal SEO et complique le travail de Google pour identifier la source originale.
La solution passe par une politique de canonicalisation stricte. Dès la création du document, intégrez l’URL canonique dans les métadonnées du PDF. Ajoutez un en-tête HTTP côté serveur lorsque c’est techniquement possible. Et n’oubliez pas le lien textuel visible à l’intérieur du fichier. Ces trois couches de signalisation aident Google à regrouper correctement les différentes versions et à attribuer l’autorité à la bonne URL.
Pour les documents qui évoluent régulièrement, la règle est simple : nouvelle version, nouvelle URL. Évitez de remplacer un fichier existant sous la même adresse. Google récrawlant rarement les PDF, le risque est grand de voir d’anciennes informations continuer à circuler pendant des mois.
Optimiser l’expérience utilisateur au-delà de l’indexation
Même si l’indexation est l’enjeu principal de cet article, il ne faut pas négliger l’expérience de lecture. Un PDF de 80 pages téléchargé sur un smartphone reste difficile à consulter. Les utilisateurs abandonnent souvent avant d’atteindre les informations importantes. La version HTML, en revanche, peut être conçue pour le mobile dès le départ. Elle peut intégrer des ancres de navigation, des tableaux filtrables ou des appels à l’action contextuels.
Le PDF conserve néanmoins des avantages indéniables. Il garantit une mise en page stable, indépendante du navigateur. Il se partage facilement par e-mail. Il peut être annoté avec des outils professionnels. Pour de nombreuses audiences B2B, ces qualités restent déterminantes. L’idéal est donc de laisser le choix à l’utilisateur : lire en ligne sur une page optimisée ou télécharger la version complète.
Mesurer l’impact réel de vos PDF dans la Search Console
Avant de décider quels documents transformer en HTML, basez-vous sur des données concrètes. Ouvrez la Search Console et filtrez les URL qui se terminent par .pdf. Observez les impressions, les clics et la position moyenne. Les fichiers qui génèrent déjà du trafic organique sont prioritaires. Ceux qui n’apparaissent jamais dans les rapports peuvent être laissés de côté dans un premier temps, ou simplement optimisés pour le téléchargement.
Cette analyse permet aussi d’identifier les requêtes pour lesquelles vos PDF se positionnent. Vous découvrirez parfois que certains documents captent des mots-clés de longue traîne très qualifiés. Ces insights sont précieux pour enrichir la version HTML correspondante et renforcer encore le positionnement.
Les erreurs à éviter absolument avec les PDF
Certaines pratiques restent contre-productives malgré les clarifications de Google. Évitez de créer des PDF purement image, même s’ils sont plus beaux visuellement. Ne protégez jamais par mot de passe la version destinée à l’indexation. N’utilisez pas la même URL pour des versions successives d’un même document. N’oubliez pas d’inclure des liens textuels vers vos pages importantes. Et surtout, ne considérez pas le PDF comme un format de substitution à une véritable page web.
Une autre erreur fréquente consiste à négliger les métadonnées. Titre, auteur, sujet et mots-clés internes au fichier peuvent aider Google à mieux comprendre le contenu. Même si leur poids est moindre que celui d’une balise title HTML, ils participent à la qualité globale du signal.
Vers une coexistence intelligente entre HTML et PDF
L’épisode 115 de Search Off the Record ne signe pas la mort du PDF. Il clarifie simplement sa place dans l’écosystème SEO. Le format reste parfaitement adapté à la diffusion de contenus longs, techniques ou destinés à être téléchargés. Il peut même alimenter les fonctionnalités d’intelligence artificielle de Google. Mais il ne doit plus être le seul support de publication pour les contenus stratégiques.
Les équipes marketing qui réussiront dans les prochaines années seront celles qui sauront combiner les forces des deux formats. Une page HTML soignée pour la découverte et le classement. Un PDF de qualité pour la conversion et le partage hors ligne. Cette double présence, correctement signalée par des liens et des balises canoniques, offre la meilleure chance d’apparaître à la fois dans les résultats classiques et dans les synthèses générées par l’IA.
Pour les startups et les scale-ups qui construisent leur présence digitale, le message est clair. Investissez d’abord dans des pages web performantes. Utilisez ensuite le PDF comme un outil complémentaire de génération de leads et de diffusion d’expertise. Testez systématiquement l’extractibilité du texte. Surveillez les performances dans la Search Console. Et n’hésitez pas à republier sous une nouvelle URL chaque version majeure de vos documents de référence.
Checklist pratique pour auditer vos PDF existants
Avant de clore cet article, voici une liste de contrôle que vous pouvez appliquer immédiatement à votre bibliothèque de documents :
- Le texte se sélectionne-t-il et se copie-t-il facilement ?
- Le fichier est-il protégé par un mot de passe ?
- La taille dépasse-t-elle inutilement les 20 Mo ?
- Existe-t-il déjà une version HTML du même contenu ?
- Des liens textuels pointent-ils vers les pages importantes du site ?
- Les métadonnées contiennent-elles l’URL canonique ?
- Le document apparaît-il dans les performances de la Search Console ?
- Une nouvelle version a-t-elle été publiée sous une URL différente ?
En passant chaque fichier au crible de ces questions, vous identifierez rapidement les actions prioritaires. Certains documents mériteront une refonte complète en HTML. D’autres pourront simplement être optimisés. L’essentiel est de ne plus publier de PDF « à l’aveugle », sans tenir compte des mécanismes d’indexation désormais explicitement décrits par Google.
Conclusion : un format utile, mais plus jamais exclusif
Les clarifications apportées par Martin Splitt et John Mueller en octobre 2026 mettent fin à plusieurs années d’incertitude. Oui, Google indexe les PDF. Oui, ils peuvent apparaître dans les AI Overviews. Oui, le robot accepte jusqu’à 64 Mo. Mais non, le PDF n’est pas le format idéal pour maximiser la visibilité organique. Le HTML reste supérieur sur presque tous les critères qui comptent vraiment : fréquence de crawl, expérience mobile, éligibilité des images et vitesse de mise à jour.
Pour les professionnels du marketing digital, du content marketing et du SEO, la feuille de route est désormais claire. Continuez à produire des documents PDF de haute qualité pour convertir et fidéliser. Mais doublez systématiquement les contenus stratégiques d’une version HTML soignée. Signalez correctement les relations canoniques. Surveillez les performances. Et traitez chaque nouveau livre blanc ou chaque nouvelle fiche technique comme une opportunité de renforcer à la fois votre autorité et votre pipeline de leads.
Dans un paysage où l’intelligence artificielle de Google s’appuie de plus en plus sur des sources fiables et extractibles, les entreprises qui maîtriseront cette dualité HTML-PDF prendront une longueur d’avance. Le format PDF n’est pas mort. Il vient simplement de trouver sa juste place aux côtés du web, plutôt qu’à sa place.