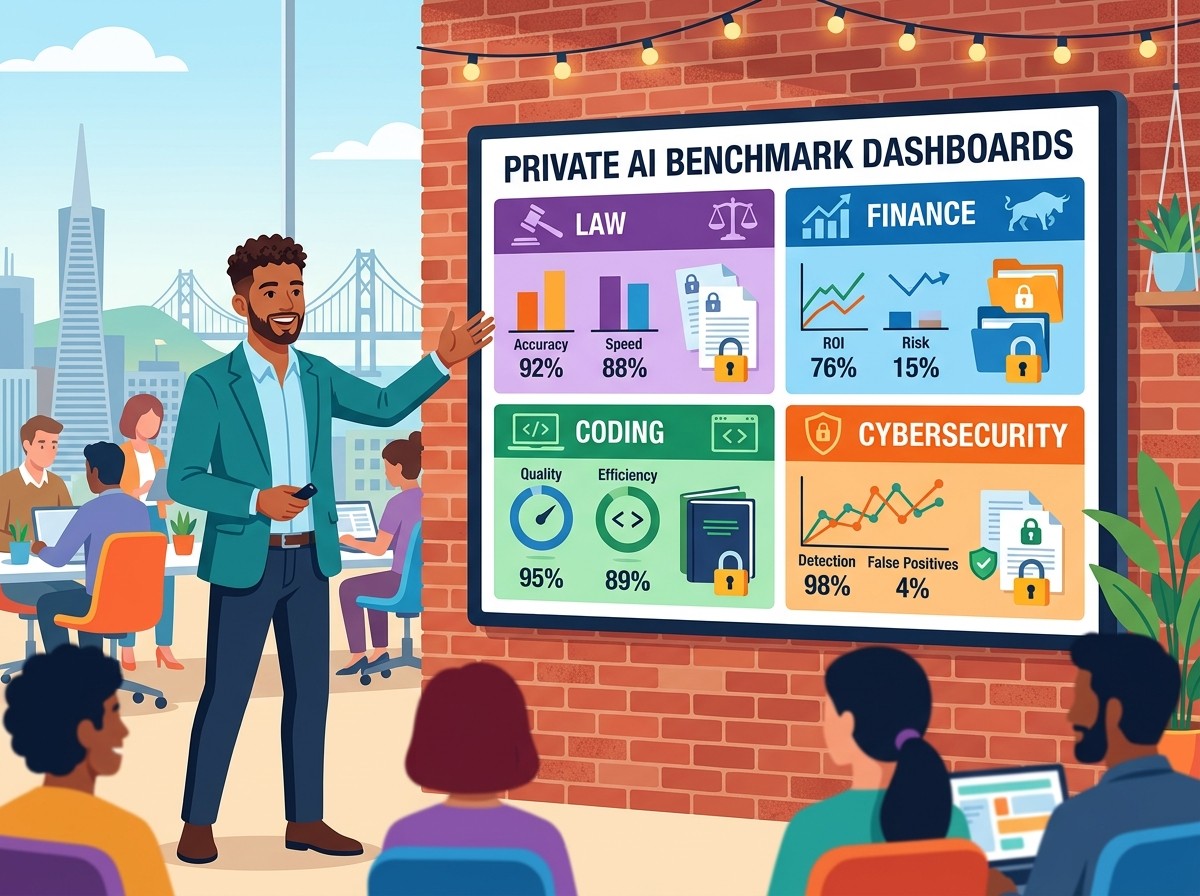

Et si le plus grand avantage concurrentiel d’un modèle d’intelligence artificielle n’était plus le nombre de paramètres, ni le communiqué de lancement, mais une note que personne ne peut truquer ? Dans un marché où chaque labo brandit des scores records, une startup californienne de moins de deux ans affirme qu’il est temps de changer d’examen. TechCrunch raconte l’ascension de Vals, soutenue par Andreessen Horowitz, qui veut devenir l’étalon or du benchmarking IA. Pour les équipes marketing, les fondateurs et les investisseurs, ce n’est pas un détail technique : c’est le nouveau langage de la preuve.
Pourquoi Les Benchmarks Classiques Ne Suffisent Plus
Les classements publics ont longtemps servi de carte de visite. Un modèle passe un QCM académique, le score grimpe, la communication s’emballe. Le problème, c’est que beaucoup de ces épreuves sont anciennes, trop génériques, et surtout disponibles en ligne. Un laboratoire peut donc entraîner son système sur les questions elles-mêmes. L’examen n’évalue plus la compétence : il récompense la mémorisation du barème.
Rayan Krishnan, cofondateur de Vals à seulement 25 ans, a vu ce décalage de l’intérieur. Passage par Palantir, Microsoft, le laboratoire d’IA de Stanford : il a observé des modèles de plus en plus capables arriver sur le marché plus vite que les grilles de notation destinées à les mesurer. Quand l’IA s’insère dans le droit, la finance, le code ou la santé mentale, un quiz de culture générale ne dit presque rien de la valeur réelle du produit.
Nous voyions arriver très vite de nouveaux modèles très capables, et les benchmarks académiques n’arrivaient plus à suivre cette frontière.
– Rayan Krishnan, cofondateur de Vals
Pour une marque B2B, l’enjeu est brutal. Promettre « un copilote juridique de niveau associé » sans preuve métier, c’est s’exposer à un écart de perception dès le premier pilote client. Le benchmarking cesse d’être un accessoire de relations presse : il devient un argument de vente, un outil de priorisation produit et, demain, un élément de dossier réglementaire.
Vals, Une Startup Née Pour Recoller La Mesure À La Réalité
Créée en 2024, Vals a d’abord levé un tour d’amorçage mené par 8VC et Bloomberg Beta. Après une phase de croissance rapide, la société a annoncé un Series A de 40 millions de dollars mené par Andreessen Horowitz. En moins de deux ans, elle s’est imposée comme un acteur que les labs et les entreprises commencent à consulter avant d’acheter, d’intégrer ou de vanter un modèle.
Le siège, sur Folsom Street à San Francisco, occupe une ancienne brasserie de brique. L’image est presque trop belle pour être inventée : là où l’on brassait de la bière il y a un siècle, on brasse aujourd’hui des protocoles d’évaluation. Krishnan y a récemment fait visiter les deux étages à un journaliste de TechCrunch. L’ambiance startup est classique. L’ambition l’est moins : remplacer l’idée d’une intelligence abstraite par la capacité à livrer un travail comparable à celui d’un humain dans un domaine donné.
Historiquement, on demandait surtout : le modèle sait-il assez de choses pour réussir un examen du barreau ? Vals inverse la question. Le modèle peut-il produire un livrable de qualité professionnelle ? Peut-il aussi échouer de manière dangereuse si on le laisse « courir dans le monde réel » ? Mesurer le succès ne suffit plus. Il faut cartographier les dégâts possibles.
Des Tests Privés Pour Empêcher Le Bachotage Des Modèles
La première décision stratégique de Vals est presque contre-intuitive dans une industrie obsédée par l’open source et la transparence des classements : les sujets ne sont pas publics. Si tout le monde peut lire l’épreuve, tout le monde peut s’y entraîner. Le score cesse alors d’être une mesure indépendante. Il devient un trophée de data leakage.
Cette opacité n’est pas un caprice. Elle rappelle le fonctionnement d’un examen standardisé : on paie pour passer l’épreuve, on ne récupère pas le livret pour l’injecter dans un fine-tuning. Krishnan compare d’ailleurs le modèle économique à celui du College Board et du SAT. L’étudiant ne paie pas pour entendre qu’il est brillant. Il paie pour obtenir une mesure reconnue, même si le résultat est décevant.
Pour les directions produit, l’intérêt est double. D’un côté, un mauvais score devient un diagnostic : où le modèle hallucine, où il ignore une contrainte métier, où il sous-performe un junior. De l’autre, un bon score devient un argument commercial plus solide qu’un leaderboard communautaire. Dans un pitch, « premier sur un benchmark public saturé » pèse moins que « capable de produire un livrable finance ou legal au niveau attendu par un expert ».
Évaluer Le Travail Réel, Pas La Culture Générale
Vals ne se contente pas de cacher les questions. Elle change l’objet de la mesure. Au lieu de tester une connaissance encyclopédique, la société évalue des tâches complexes liées à des industries : droit, finance, développement logiciel. L’unité de valeur n’est plus la bonne réponse isolée, c’est le produit fini, sa cohérence, sa conformité, son utilité.
Cette bascule parle directement aux acheteurs d’entreprise. Un DSI n’achète pas un modèle parce qu’il récite des dates. Il l’achète parce qu’il rédige une clause, analyse un flux financier, débogue une base de code ou oriente une décision sous contrainte. Le marketing IA a trop longtemps vendu l’intelligence comme une aura. Les clients, eux, achètent un output.
Nous regardons les impacts réels des modèles. Peuvent-ils faire un travail dont la qualité égale celle d’un humain dans chaque domaine ?
– Rayan Krishnan
La grille inclut aussi les conséquences négatives. Si ces systèmes « tournaient en liberté », quels dommages collatéraux apparaîtraient ? Cette question rapproche le benchmarking de la gestion des risques. Elle intéresse autant les équipes comm’ que les juristes, les RSSI et les investisseurs qui devront bientôt expliquer leurs choix dans des documents publics.
Des Terrains Plus Sensibles Que Le Classique Leaderboard
Le catalogue de Vals s’étend au-delà des verticales « rassurantes ». Krishnan évoque un benchmark sur l’recursive self improvement, des travaux en santé mentale, cybersécurité, biosécurité, et même sur le droit des conflits armés pour observer comment des modèles appliqueraient les conventions de Genève. Autrement dit : on ne note plus seulement la productivité. On sonde la responsabilité.
Pour une audience marketing et startup, ces domaines ne sont pas anecdotiques. Ils dessinent le prochain champ de différenciation. Dire « notre modèle est sûr » sans protocole indépendant devient aussi fragile que dire « notre acquisition est gratuite » sans unit economics. Les verticales à fort risque réglementaire seront les premières à exiger des preuves externes.
- Droit et conformité documentaire
- Finance et qualité des livrables d’analyse
- Ingénierie logicielle et robustesse du code
- Cybersécurité et biosécurité
- Santé mentale et usages sensibles
- Amélioration récursive des systèmes
Chacun de ces axes peut devenir un argument de positionnement. Encore faut-il que la preuve soit plus solide que le slogan. C’est précisément le vide que Vals cherche à occuper : une mesure que l’on ne peut pas « optimiser » en recyclant les annales.
Un Modèle Économique Qui Déroute… Puis Devient Évident
Pourquoi une entreprise paierait-elle pour découvrir que son modèle est moyen ? Parce qu’un chiffre indépendant coûte moins cher qu’un échec client, qu’une crise de confiance ou qu’un cycle produit mal orienté. Vals facture l’évaluation. Les laboratoires et les entreprises achètent une photographie de performance, puis s’en servent pour corriger, arbitrer et communiquer.
Ces notes commencent à peser dans les décisions d’achat de modèles. Ce n’est plus seulement le labo qui se compare à ses rivaux. C’est l’entreprise cliente qui compare deux fournisseurs avant de signer. Dans une stack IA, le benchmark devient un critère de sélection au même titre que le prix du token, la latence ou la politique de rétention des données.
La société aurait multiplié son revenu par huit en un an. L’équipe, partie de huit personnes en début d’année, serait déjà passée à vingt-cinq, avec l’intention d’embaucher encore dix à quinze profils et de déménager dans un bureau plus grand. Vals a aussi lancé un programme d’évaluations destiné aux agences fédérales. Quand l’État entre dans la boucle, la mesure cesse d’être un gadget de startup pour devenir une infrastructure de confiance.
Ce Que Cela Change Pour Le Marketing Des Produits IA
Les équipes communication ont pris l’habitude de transformer chaque point de benchmark en accroche. Le geste n’est pas illégitime. Il devient risqué lorsque le public apprend que le test était connu à l’avance. La crédibilité d’une campagne dépend désormais de la non-contaminabilité de la preuve.
Un narratif plus solide pourrait ressembler à ceci : voici la tâche métier, voici le protocole indépendant, voici ce que le modèle réussit, voici ce qu’il rate encore. Moins de superlatifs, plus de frontière d’usage. Paradoxalement, admettre les limites peut accélérer l’adoption. Les acheteurs d’entreprise détestent les boîtes noires plus que les scores imparfaits.
Les startups qui vendent des wrappers autour de grands modèles ont un intérêt particulier. Leur différenciation tient souvent à l’orchestration, aux garde-fous, aux données propriétaires. Un benchmark métier permet de montrer que le wrapper n’est pas qu’une interface jolie : il améliore réellement le livrable. Sans cela, le marché réduit le produit à une surcouche interchangeable.
Investisseurs, Introductions En Bourse Et Preuve Publique
Krishnan pousse le raisonnement jusqu’au marché financier. Des acteurs de l’IA se préparent à une vie de société cotée. Il évoque SpaceX déjà public selon ses propos rapportés, Anthropic attendu plus tard dans l’année, OpenAI potentiellement ensuite. Quand un modèle devient un actif économique central, les évaluations cesseront d’être de simples slides de lancement. Elles pourront irriguer les discussions d’investissement et, à terme, certains documents destinés au marché.
À mesure que les modèles se diffusent dans l’économie, le type de benchmarks que nous menons va orienter leur usage et devenir central dans la façon dont ces entreprises parlent de leurs investissements.
– Rayan Krishnan
Pour un fonds ou un corporate venture, la leçon est claire. Diligence d’un actif IA sans protocole d’évaluation indépendant, c’est un peu comme valoriser une marketplace sans regarder la rétention. Le storytelling produit ne remplace pas une mesure difficile à gamer. Vals mise sur cette bascule : la confiance se paie, parce que l’absence de confiance coûte plus cher.
Le Portrait D’Un Fondateur Calibré Pour Cette Thèse
À 25 ans, Krishnan incarne une génération qui n’a pas connu l’IA comme un sujet de laboratoire isolé, mais comme une infrastructure déjà déployée. Stage Palantir, passage Microsoft, travail au labo d’IA de Stanford : le parcours est celui d’un observateur situé entre la recherche, l’industrie de la donnée et le produit. Vals naît d’un constat d’écart, pas d’une mode de plus sur les agents.
Ce type de profil rassure les investisseurs late seed / Series A : assez technique pour concevoir des protocoles, assez exposé à l’entreprise pour vendre une mesure plutôt qu’un jouet de recherche. Le timing aide. Le marché est saturé de démos. Il est sous-doté en arbitres.
L’article de TechCrunch insiste aussi sur un point culturel : l’évaluation a trop longtemps visé une intelligence désincarnée. Vals cherche l’impact. Cette phrase peut sembler marketing. Elle décrit pourtant le basculement que toutes les équipes growth observent déjà chez leurs clients : on ne demande plus si le modèle « a l’air intelligent ». On demande s’il réduit le temps de cycle, le risque d’erreur et le coût d’un expert.
Ce Que Les Startups Peuvent Copier Dès Maintenant
Inutile d’attendre d’avoir 40 millions en banque pour appliquer la logique. Toute équipe qui vend de l’IA peut construire une discipline d’évaluation plus honnête. Pas nécessairement avec Vals le premier jour. Mais avec des principes voisins : sujets non recyclables, tâches proches du travail réel, mesure des échecs autant que des succès, communication des limites.
- Définir 10 tâches métier que le client paie réellement
- Faire scorer les livrables par des experts humains, pas seulement par un LLM juge
- Séparer le jeu d’entraînement et le jeu d’examen
- Publier aussi les cas d’échec et les seuils de non-utilisation
- Relier chaque claim marketing à une preuve reproductible
Cette hygiène change le ton commercial. Au lieu de promettre l’autonomie totale, on vend un périmètre maîtrisé. Les taux de conversion des pilots s’améliorent souvent quand l’attente est cadrée. Le benchmark n’est plus un feu d’artifice. C’est un contrat de réalité.
Risques, Critiques Et Zones D’Ombre À Surveiller
Faire d’un acteur privé l’étalon or n’est pas anodin. Qui écrit les grilles détient un pouvoir de marché. Si les tests restent secrets, comment la communauté scientifique discute-t-elle la validité du protocole ? Si les clients sont aussi les laboratoires évalués, comment garantir l’indépendance perçue ? Ces tensions n’annulent pas la thèse. Elles obligent à la maturité.
Autre écueil : transformer le benchmark métier en nouveau theatre. On peut très bien concevoir des tâches « réalistes » trop étroites, trop américaines, trop juridiques, trop commodes pour un type de modèle. L’étalon or d’aujourd’hui peut devenir le QCM d’hier si personne n’en audit la représentativité. La qualité d’une mesure se juge à ce qu’elle refuse de flatter.
Enfin, le marché français et européen ajoutera ses propres contraintes : documentation du règlement sur l’IA, exigences sectorielles, responsabilité du fournisseur. Une startup californienne peut devenir une référence de fait. Elle ne remplacera pas, à elle seule, un cadre de conformité local. Les équipes européennes auront intérêt à articuler évaluation privée, preuves internes et obligations réglementaires.
Une Nouvelle Grammaire De La Confiance
Vals ne promet pas d’inventer une intelligence supérieure. Elle promet de mieux dire ce que font déjà les systèmes. Dans une économie où l’IA devient un poste budgétaire, un argument de marque et bientôt un chapitre de document d’investisseur, cette modestie est stratégique. La confiance ne se décrète pas dans un thread de lancement. Elle se construit avec des épreuves que l’on ne peut pas réviser la veille.
Pour les lecteurs qui construisent, financent ou racontent des produits technologiques, le signal est net. Les superlatifs s’essoufflent. Les protocoles montent en grade. Ceux qui sauront relier une promesse commerciale à une tâche réelle, mesurée, éventuellement payante et difficile à truquer, parleront la langue du prochain cycle. Les autres continueront de gagner des captures d’écran. Pas forcément des renouvellements.
Le benchmarking n’est plus un accessoire de laboratoire. C’est un levier de positionnement, un filtre d’investissement et un instrument de responsabilité. Vals, avec le soutien d’Andreessen Horowitz et une croissance déjà visible, parie que le marché est prêt à payer pour savoir. Dans un secteur saturé de démonstrations, savoir reste le luxe le plus rare.